1. 评价方法
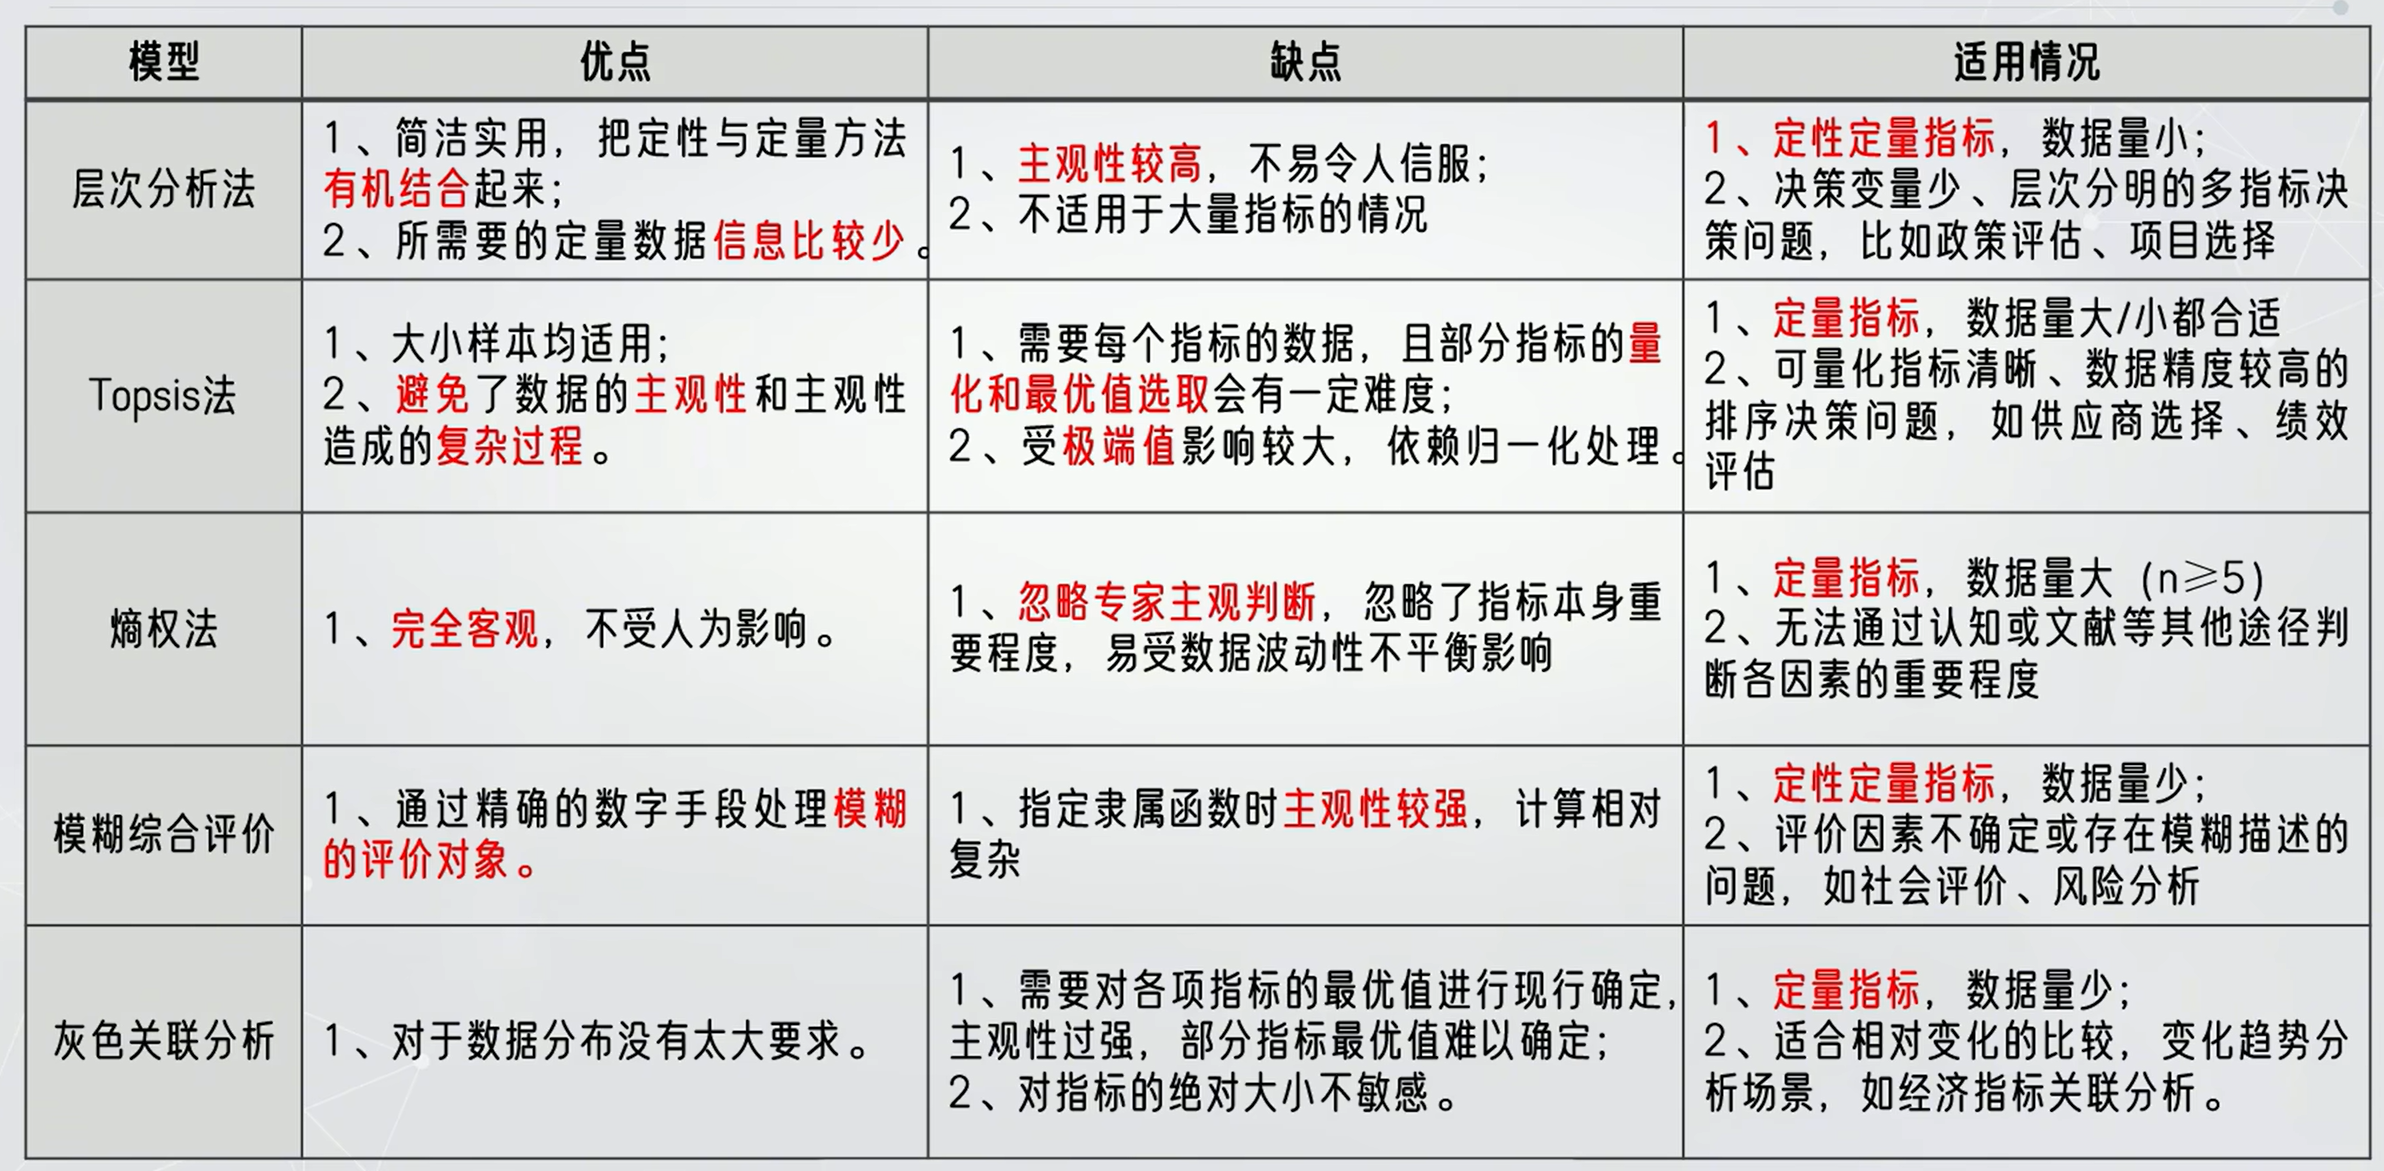
1.1 层次分析法
1.1.1 介绍
层次分析法的主要特点是把人类的判断转化到若干因素两两之间的重要度的比较上 比如微博要选出一个明星作为微博之星,现在有三个候选明星A、B、C,如何选择?考虑一个明星的成就可以看其粉丝数、颜值、作品数量、作品质量,数据归一化后如下
| 明星 | 粉丝数 | 颜值 | 作品质量 | 作品数量 | 评分 |
|---|---|---|---|---|---|
| A | 0.4 | 0.42 | 0.29 | 0.25 | |
| B | 0.23 | 0.25 | 0.37 | 0.45 | |
| C | 0.37 | 0.33 | 0.34 | 0.30 |
最终的评分应该是各个数值的加权和,但这个权重该如何决定?
1.1.2 方法
此时可以使用层次分析法来决定,步骤如下
- 建立递阶层次结构模型
- 构造各层次的判断矩阵
- 一致性检验
- 求权重后进行评价
递阶层次结构模型
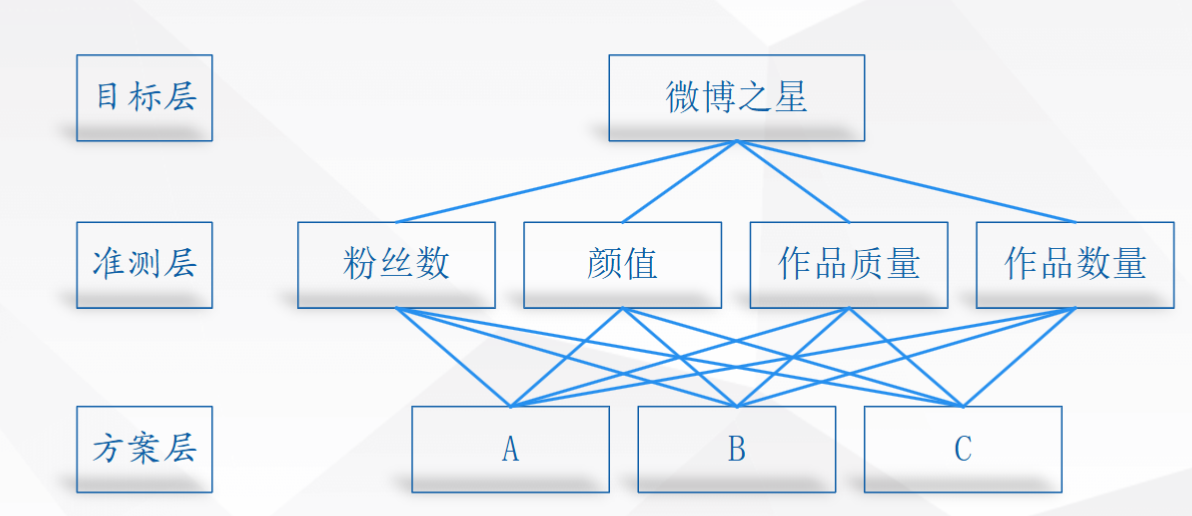
构造出各层次中的所有判断矩阵
- 对指标的重要性进行两两比较,构造判断矩阵,从而科学求出权重
- 矩阵中元素\(a_{ij}\) 的意义是,第𝑖个指标相对第𝑗个指标的重要程度
- 矩阵如下,数字越大,代表更重要,注意这一定是个实对称矩阵
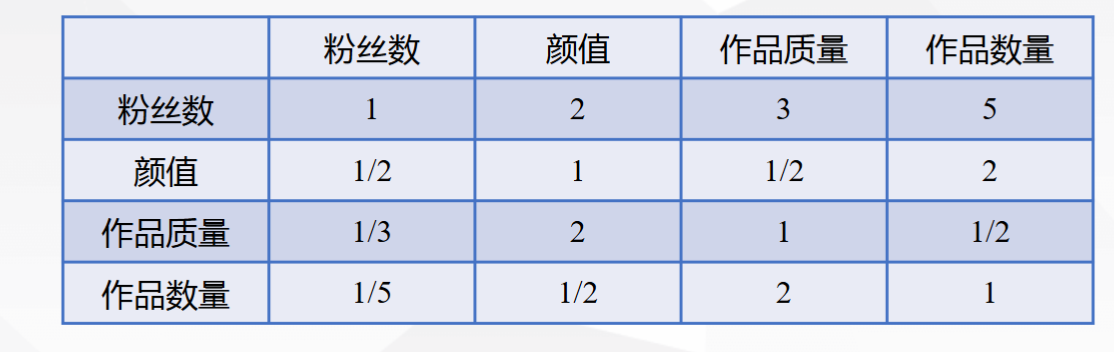
因两两比较的过程中忽略了其他因素,导致最后的结果可能出现矛盾
如上表可以看出\(a_{23}\) =1/2代表在重要性上,颜值不如作品质量; \(a_{24}\)=2代表着颜值比作品数量重要,因此可以看出作品质量比作品数量重要,但\(a_{34}\)= 1/2意味着作品质量不如作品数量重要,与上一条矛盾!
所以需要一致性检验去验证
一致性检验
定义:若矩阵满足\(a_{ij}>0、a_{ij}*a_{ji}=1\),且\(a_{ik}=a_{ij}a_{jk}\),则被称为一致性矩阵。
由于判断矩阵\(a_{ij}=\frac{i重要性}{j重要性},a_{jk}=\frac{j重要性}{k重要性}\)
易得 \(a_{ik}=\frac{i重要性}{j重要性}*\frac{j重要性}{k重要性}=a_{ij}a_{jk}\)
所以判断矩阵必须是一致性矩阵
=>矩阵各行(列)成倍数关系。
=>rank=1
=> 有唯一特征值p=n(迹,对角线之和),而特征向量则是各个指标在空间上的分量
具体检验步骤
- 计算一致性指标CI
\(CI=\frac{\lambda_{max}-n}{n-1}\)
查找对应的平均随即一致性指标RI
n 1 2 3 4 5 6 … RI 0 0 0.52 0.89 1.12 1.26 计算一致性
\(CR=\frac{CI}{RI}\),如果\(CR<0.1\),则矩阵一致
求权重并得出评分
RI介绍
RI是通过对大量随机判断矩阵的一致性进行统计分析得出的。通过随机选择一组数值(通常从1到9之间),构建多个随机判断矩阵。这些矩阵是没有实际意义的,完全是随机生成的。
对每个随机矩阵,计算其特征根(最大特征值),然后用该特征根计算一致性指数(CI)。CI的计算公式为:\(CI=\frac{\lambda_{max}-n}{n-1}\),对于不同阶数的随机判断矩阵,计算出一组CI值的平均值,这个平均值就是对应阶数的RI值。RI的值是固定的,只随着矩阵阶数的增加而变化。
1.1.3 案例
当前判断矩阵的\(\lambda_{max}\) = 4.68,𝑛 = 4,求得𝐶 = 0.227,查表𝑅I=0.89,得CR = 0.255。
则需要修改矩阵(完美情况下,不可以根据结果来修改,而是得更多调研和参考专家意见)
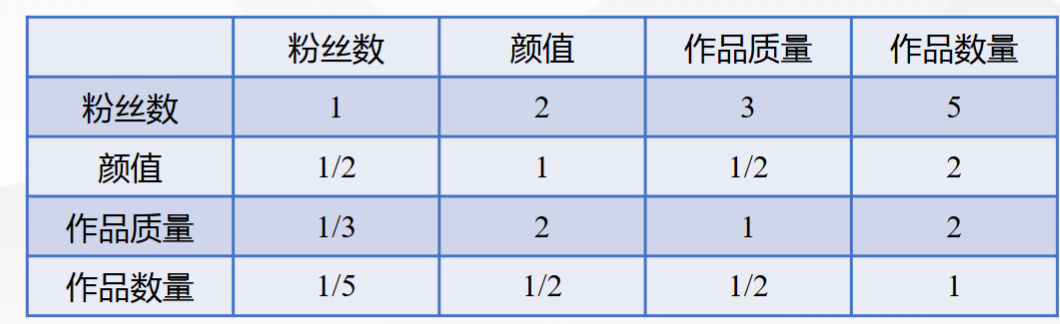
此时CR=0.0418,满足条件
import numpy as np

# 定义矩阵A
A = np.array([[1, 2, 3, 5], [1/2, 1, 1/2, 2], [1/3, 2, 1, 2], [1/5, 1/2, 1/2, 1]])

n = A.shape[0]
eig_val, eig_vec = np.linalg.eig(A)
Max_eig = max(eig_val)

CI = (Max_eig - n) / (n-1)
RI = [0, 0.0001, 0.52, 0.89, 1.12, 1.26, 1.36, 1.41, 1.46, 1.49, 1.52, 1.54, 1.56, 1.58, 1.59]

CR = CI / RI[n]

print('一致性指标CI=', CI)
print('一致性比例CR=', CR)

if CR < 0.10:
    print('因为CR<0.10,所以该判断矩阵A的一致性可以接受!')
else:
    print('注意:CR >= 0.10,因此该判断矩阵A需要进行修改!')


# 算术平均
ASum = np.sum(A, axis=0)
Stand_A = A / ASum
weights = np.mean(Stand_A, axis=1)
print(weights)

# 几何平均
n, _ = A.shape
prod_A = np.prod(A, axis=1)
prod_n_A = np.power(prod_A, 1/n)
re_prod_A = prod_n_A / np.sum(prod_n_A)
print(re_prod_A)

# 特征值法
eig_values, eig_vectors = np.linalg.eig(A)
max_index = np.argmax(eig_values)
max_vector = eig_vectors[:, max_index]
weights = max_vector / np.sum(max_vector)
print(weights)
1.2 Topsis
TOPSIS是一种多准则决策分析方法,用于在多个备选方案中选择最优方案。该方法基于离理想解的距离来评估和排序各个方案,认为最优的方案是与理想解最接近、与负理想解最远的方案。
1.2.1方法
构建决策矩阵
标准化决策矩阵
为了消除不同指标量纲的影响,通常对决策矩阵进行归一化和正向化 3. 确定理想解和负理想解
- 理想解:在所有备选方案中,每个指标的最大值构成理想解。
- 负理想解:每个指标的最小值构成负理想解。
即: \[ A^+ = \left( \max(x'_{ij}) \quad \text{for all} \, j \right) \] \[ A^- = \left( \min(x'_{ij}) \quad \text{for all} \, j \right) \]
- 计算每个方案与理想解和负理想解的距离
对于每个备选方案,计算其与理想解和负理想解的欧氏距离:
- 方案$ i \(与理想解的距离:\)$ D_i^+ = $$
- 方案$ i \(与负理想解的距离:\)$ D_i^- = $$
- 计算方案的相对接近度
相对接近度(closeness coefficient)是方案与理想解的距离与总距离的比值。公式如下: \[ C_i = \frac{D_i^-}{D_i^+ + D_i^-} \] 其中,$ C_i $的值介于0和1之间,值越大表示方案越接近理想解,越优。
- 排序
根据每个方案的接近度$ C_i \(值,排序所有方案,\) C_i $值越大的方案越优。
1.2.2 矩阵正向化
将原始矩阵正向化,就是要将所有的指标类型统一转化为极大型指标,目的是为了统一不同类型的指标,使得后续的标准化和评分计算更加方便和一致。
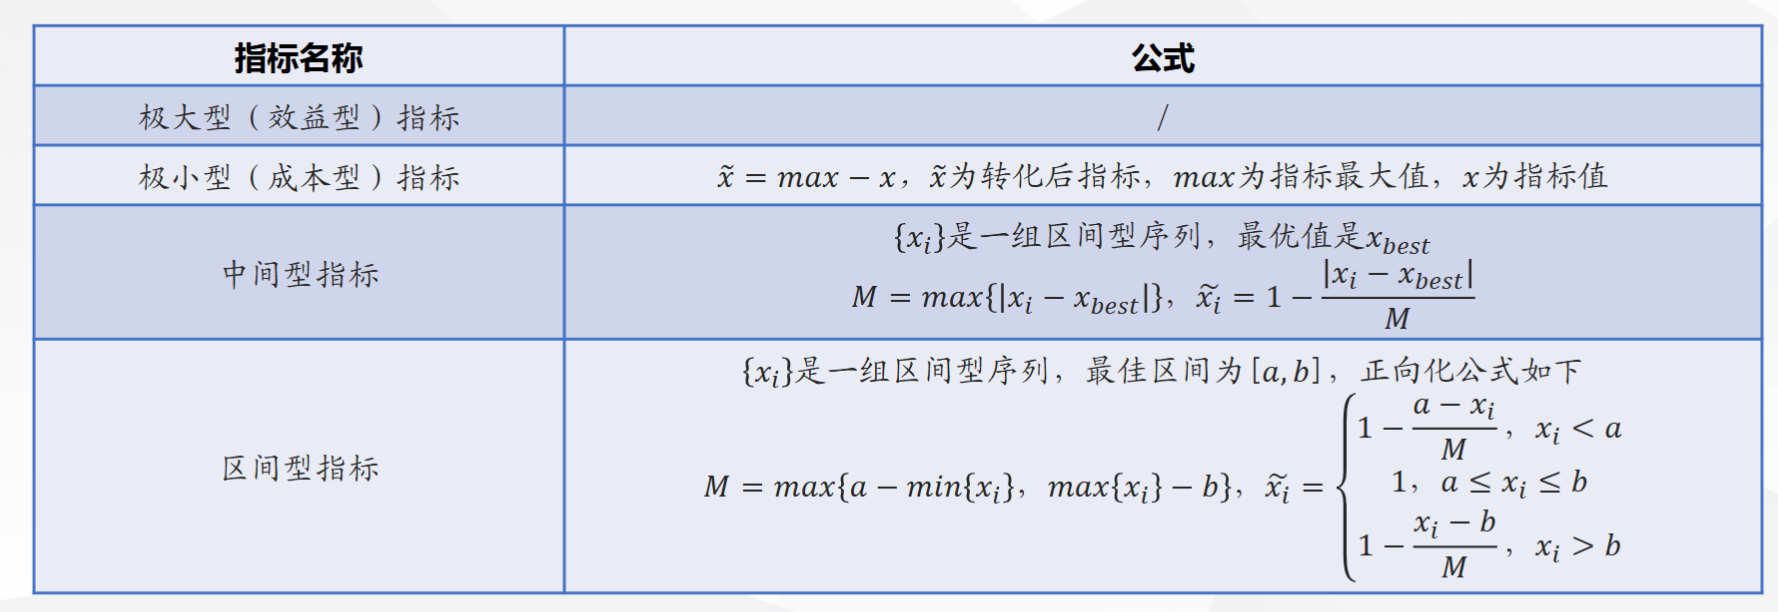
1.2.3 案例
import numpy as np

def minTomax(maxx, x):
    x = list(x)
    ans = [[(maxx-e)] for e in x]
    return np.array(ans)

def midTomax(bestx, x):
    x = list(x)
    h = [abs(e-bestx) for e in x]
    M = max(h)
    if M == 0:
        M = 1  # 防止最大差值为0的情况
    ans = [[(1-e/M)] for e in h]  # 计算每个差值占最大差值的比例,并从1中减去,得到新指标值
    return np.array(ans)

def regTomax(lowx, highx, x):
    x = list(x)
    M = max(lowx-min(x), max(x)-highx)
    if M == 0:
        M = 1  # 防止最大距离为0的情况
    ans = []
    for i in range(len(x)):
        if x[i]<lowx:
            ans.append([(1-(lowx-x[i])/M)])
        elif x[i]>highx:
            ans.append([(1-(x[i]-highx)/M)])
        else:
            ans.append([1])
    return np.array(ans)

if __name__ == '__main__':

    print("类型矩阵:1:极大型,2:极小型,3:中间型,4:区间型")
    kind = [[1],[2],[3,165],[4,[90,100]]]

    A=[[9,10,175,120],[8,7,164,80],[6,3,157,90]]

    A = np.array(A)
    n, m = A.shape

    X = np.zeros(shape=(n, 1))

    for i in range(m):
        match kind[i][0]:
            case 1:
                v = np.array(A[:, i])
            case 2:
                maxA = max(A[:, i])
                v = minTomax(maxA, A[:, i])
            case 3:
                bestA = kind[i][1]
                v = midTomax(bestA, A[:, i])
            case 4:
                lowA = kind[i][1][0]
                highA = kind[i][1][1]
                v = regTomax(lowA, highA, A[:, i])
        if i==0:
            X = v.reshape(-1, 1)
        else:
            X = np.hstack([X, v.reshape(-1, 1)])
    print("统一指标后矩阵为:\n{}".format(X))  # 打印处理后的矩阵X


    X = X.astype('float')
    for j in range(m):
        X[:, j] = X[:, j]/np.sqrt(sum(X[:, j]**2))  # 欧几里得范数


    x_max = np.max(X, axis=0)
    x_min = np.min(X, axis=0)
    d_z = np.sqrt(np.sum(np.square((X - np.tile(x_max, (n, 1)))), axis=1))
    d_f = np.sqrt(np.sum(np.square((X - np.tile(x_min, (n, 1)))), axis=1))

    s = d_f/(d_z+d_f)
    Score = 100*s/sum(s)
    for i in range(len(Score)):
        print(f"score {i+1}: {Score[i]:.2f}%")
1.3 熵权法
熵权法是一种用于多准则决策分析的方法,基于信息熵的概念,通过分析决策矩阵中的信息量来确定各个准则的权重。熵权法的基本思想是,信息熵越大,表明该准则的信息越分散,权重应相应降低;反之,信息熵越小,表明该准则的信息越集中,权重应相应提高。
1.3.1 方法
构建决策矩阵
标准化决策矩阵
计算各准则的信息熵
对于每个准则,计算其信息熵。信息熵反映了准则的信息不确定性,计算公式如下: \[ H_j = -\frac{1}{\ln m} \sum_{i=1}^{m} p_{ij} \ln(p_{ij}) \] 其中,$ p_{ij} \(为标准化后的决策矩阵元素,计算公式为:\)$ p_{ij} = $$ $ H_j $表示第( j )个准则的信息熵。
- 计算准则的权重
根据信息熵,计算各准则的权重。熵值越小,权重越大。权重的计算公式为: \[ w_j = \frac{1 - H_j}{\sum_{j=1}^{n} (1 - H_j)} \] 其中,$ w_j $表示第( j )个准则的权重。
1.3.2 案例
import numpy as np

def entrop(p):
    n = len(p)
    lnp = np.zeros(n)
    for i in range(n):
        if p[i] != 0:
            lnp[i] = p[i]*np.log(p[i])
    return lnp

if __name__ == "__main__":
    X = np.array([[9, 0, 0, 0], [8, 3, 0.9, 0.5], [6, 7, 0.2, 1]])

    Z = X / np.sqrt(np.sum(X*X, axis=0))

    n, m = Z.shape
    D = np.zeros(m)

    for i in range(m):
        x = Z[:, i]
        p = x / np.sum(x)
        e = -np.sum(entrop(p)) / np.log(n)
        D[i] = 1 - e

    W = D / np.sum(D)
    print(f"{W=}")
1.4 灰色关联分析
灰色关联分析是一种用于多变量系统分析的统计方法,主要用于处理少量、不完全和不确定的数据。灰色关联分析的基本思想是通过比较各个方案之间的相似度来评估其优劣,广泛应用于复杂系统的优化、预测和决策等领域。
1.4.1 方法
构建决策矩阵
标准化决策矩阵
选择参考序列
在灰色关联分析中,通常选择某一个方案作为参考序列(理想方案或基准方案)。该方案与其他所有方案进行比较,计算它们之间的灰色关联度。
假设参考序列为\(X_0 = (x_{01}, x_{02}, \dots, x_{0n})\),其他方案为\(X_i = (x_{i1}, x_{i2}, \dots, x_{in})\),其中\(( i = 1, 2, \dots, m )\)。
- 计算灰色关联系数
灰色关联系数用于度量参考序列与其他序列之间的关联程度。其计算公式为: \[ \xi_{ij} = \frac{\min\limits_{k} \min |x_{0k} - x_{ik}| + \rho \cdot \max\limits_{k} \max |x_{0k} - x_{ik}|}{|x_{0j} - x_{ij}| + \rho \cdot \max\limits_{k} \max |x_{0k} - x_{ik}|} \] 其中,$ _{ij} \(表示第\( i \)个方案和参考序列之间的关联系数,\) \(为分辨系数,一般取值为0.5,\) j \(为当前比较的指标,\) k $为所有指标。
- 计算灰色关联度
灰色关联度是关联系数的加权平均值,表示方案之间的总体相似度。其计算公式为: \[ \Gamma_i = \frac{1}{n} \sum_{j=1}^{n} \xi_{ij} \] 其中,$ _i \(表示第\( i \)个方案与参考序列的灰色关联度,\) n $为准则的数量。
1.4.2 案例
import numpy as np

A = np.array([[55, 24, 10], [65, 38, 22], [75, 40, 18], [100, 50, 20]])
A_norm = A / np.mean(A, axis=0)

Y = A_norm[:, 0].reshape(-1, 1)
X = A_norm[:, 1:]

absX0_Xi = np.abs(X - np.tile(Y, (1, X.shape[1])))


a = np.min(absX0_Xi)
b = np.max(absX0_Xi)

rho = 0.5

gamma = (a + rho * b) / (absX0_Xi + rho * b)

print(f'各指标灰色关联度为:{np.mean(gamma, axis=0)}')
1.5 总结
2. 灰色预测GM(1,1)
灰色预测GM(1,1)是灰色系统理论中的一个常用模型,用于处理具有不完全信息、少量数据、且具有一定规律的时间序列数据。
GM(1,1)模型的基本思想是通过对历史数据进行生成(累加)处理,构建灰色系统模型,从而对未来的数据进行预测。
GM(1,1) 不是发现了数据的真实动力学,而是在“信息极度不完备时,用最小结构的动力学模型去逼近趋势
一阶线性微分方程是“最弱但还能预测的连续动力系统“
2.1基本步骤
- 原始数据序列
假设我们有一个原始的时间序列数据$ x(0) = {x^0(1), x^0(2), , x^0(n)} \(,其中\) x^0(i) \(表示第\)i\(个时刻的观测值,\) n $为数据点的数量。
- 生成数据序列
首先对原始数据进行一次累加生成,即通过以下公式将原始数据转化为累加生成序列: \[ x^1(k) = \sum_{i=1}^{k} x^0(i) \quad (k = 1, 2, \dots, n) \] 通过累加生成,原始数据序列的波动性被平滑,得到的序列$ x^1 $应为单调递增。这一操作相当于对数据进行积分。我们可以将累加生成理解为数值积分的近似,从而将原始数据转化为一个“平滑”的数据序列,便于应用微分方程进行建模。
为了得到更平滑的趋势,引入了背景值 \(z^1(k)\),把离散数值近似为光滑曲线的切线中点 \[ z^{(1)}(k)=\alpha x^{(1)}(k)+(1-\alpha)x^{(1)}(k-1) \] 其中:
- 经典 GM(1,1):取 \(\alpha=0.5\)
- 改进 GM:允许 \(\alpha\in(0,1)\) 作为可调参数
- 构建灰色微分方程
GM(1,1)模型假设数据的变化规律符合一个一阶线性微分方程: \[ \frac{dx^1(k)}{dk} + a z^1(k) = b \] 其中,$ a \(和\) b \(是常数,表示系统的灰色关联度和灰色输入项,\) z(k) $是累加生成后的数据序列。
而\(\frac{dx^1(k)}{dk}=\frac{x^1(k)-x^1(k-1)}{k-(k-1)}=x^0(k)\)
方程可转化为\(x^0(k) + a z(k) = b\)
=>数值近似形式: \(y = -ax+b\)
=>矩阵形式: \(Y=\begin{bmatrix}x&1\end{bmatrix}\begin{bmatrix}-a\\b\end{bmatrix}=X\beta\) \[ \mathbf{\beta} = \begin{bmatrix} -a\\b \end{bmatrix} \quad \text{and} \quad \mathbf{Y} = \begin{bmatrix} x^0(2)\\ x^0(3)\\ \vdots \\ x^0(n)\end{bmatrix}\quad \text{and} \quad \mathbf{X} = \begin{bmatrix} z^1(2)&1\\ z^1(3)&1\\ \vdots \\ z^1(n)&1\end{bmatrix} \]
通过最小二乘法求解这个线性方程组,可以得到$ a \(和\) b $的值。
广义逆矩阵:\(\beta=(X^TX)^{-1}(X^TY)\)
- 求解灰色模型的预测方程
灰色微分方程的通解为: \[ x^{(1)}(t) = C e^{-at} + \frac{b}{a} \]
用初值条件(灰色模型取 \(x^{(1)}(1)=x^{(0)}(1)\))可以解出:
\[ x^1(k) = \left( x^1(1) - \frac{b}{a} \right) e^{-a(k-1)} + \frac{b}{a} \] 该公式表示累加序列$ x^1(k) $在时间上的变化规律。
- 反生成处理
由于我们是对原始数据进行累加生成处理,因此在预测时,需要进行反生成来恢复原始数据的预测值。反生成公式为: \[ x^0(k) = x^1(k) - x^1(k-1) \quad (k = 2, 3, \dots, n) \] 通过反生成公式,可以得到GM(1,1)模型对原始数据的预测值。
2.2级比检验
在建立 GM(1,1) 灰色预测模型之前,需要对原始数据序列进行 级比检验,用于判断数据是否适合进行灰色建模。其本质是检验序列是否近似服从 指数变化规律。
设原始非负序列为:
\[ x(0) = \{x(0)(1), x(0)(2), \dots, x(0)(n)\} \]
定义级比为:
\[ \lambda(k) = \frac{x(0)(k-1)}{x(0)(k)}, \quad k=2,3,\dots,n \]
GM(1,1) 要求级比满足区间:
\[ e^{-\frac{2}{n+1}} \le \lambda(k) \le e^{\frac{2}{n+1}} \]
若全部级比均落入该区间,则说明原始序列 可以采用 GM(1,1) 建模;否则需对数据进行平移或平滑等预处理后再建模。
2.3 案例
import numpy as np
import matplotlib.pyplot as plt


plt.rcParams['font.sans-serif'] = ['Kaiti']
plt.rcParams['axes.unicode_minus'] = False


def gm11(x0, predict_num):
    """
    传统 GM(1,1) 模型
    参数:
        x0 : (n,) 原始数据(1D 可迭代/ndarray)
        predict_num : 向后预测期数(int)
    返回:
        result : (predict_num,) 未来预测值
        x0_hat : (n,) 对原始数据的拟合值
        relative_residuals : (n-1,) 相对残差(从第2项开始)
        eta : (n-1,) 级比偏差
    """
    x0 = np.asarray(x0, dtype=float).reshape(-1)
    n = x0.size
    if n < 2:
        raise ValueError("x0 的长度至少为 2")


    x1 = np.cumsum(x0)
    z1 = 0.5 * (x1[:-1] + x1[1:])

    #    y = kx + b 且 k = -a
    y = x0[1:]
    x = z1
    nn = n - 1

    denom = (nn * np.sum(x * x) - np.sum(x) ** 2)
    if abs(denom) < 1e-12:
        raise ZeroDivisionError("最小二乘拟合时分母过小,可能数据退化。")

    k = (nn * np.sum(x * y) - np.sum(x) * np.sum(y)) / denom
    b = (np.sum(x * x) * np.sum(y) - np.sum(x) * np.sum(x * y)) / denom
    a = -k

    x0_hat = np.zeros(n)
    x0_hat[0] = x0[0]

    for m in range(1, n):
        x0_hat[m] = (1 - np.exp(a)) * (x0[0] - b / a) * np.exp(-a * (m - 1))


    result = np.zeros(predict_num)
    for i in range(predict_num):
        m = n + i
        result[i] = (1 - np.exp(a)) * (x0[0] - b / a) * np.exp(-a * (m - 1))


    absolute_residuals = x0[1:] - x0_hat[1:]
    relative_residuals = np.abs(absolute_residuals) / x0[1:]


    class_ratio = x0[1:] / x0[:-1]

    denom_eta = (1 + 0.5 * a)
    if abs(denom_eta) < 1e-12:
        denom_eta = np.sign(denom_eta) * 1e-12
    eta = np.abs(1 - (1 - 0.5 * a) / denom_eta * (1.0 / class_ratio))

    return result, x0_hat, relative_residuals, eta

def check_input(x0):

    SMOOTH_RATIO_TH1 = 0.60
    SMOOTH_RATIO_TH2 = 0.90

    print('准指数规律检验')
    x1 = np.cumsum(x0)
    rho = x0[1:] / x1[:-1]  # 光滑度

    plt.figure(2)
    plt.plot(year[1:], rho, 'o-', label='光滑度')
    plt.plot([year[1], year[-1]], [0.5, 0.5], '-', label='临界线 0.5')
    plt.grid(True)
    plt.xticks(year[1:])
    plt.xlabel('年份'); plt.ylabel('原始数据的光滑度')
    plt.legend(loc='best')

    ind1 = 100 * np.mean(rho < 0.5)                     # 指标1:整体占比
    ind2 = 100 * np.mean(rho[2:] < 0.5) if len(x0) - 3 > 0 else np.nan  # 指标2:除前两期
    print(f'指标1:光滑比小于 0.5 的数据占比为 {ind1:.1f}%')
    if not np.isnan(ind2):
        print(f'指标2:除去前两个时期外,光滑比小于 0.5 的数据占比为 {ind2:.1f}%')


    passed = (ind1 >= 100 * SMOOTH_RATIO_TH1) and (np.isnan(ind2) or ind2 >= 100 * SMOOTH_RATIO_TH2)

    return passed


def train_val(x0,year):
    test_num = 3 if len(x0) > 7 else 2
    train_x0 = x0[:-test_num]
    test_x0 = x0[-test_num:]
    test_year = year[-test_num:]

    result1, _, _, _ = gm11(train_x0, test_num)

    # 试验组对比图
    plt.figure(3)
    plt.plot(test_year, test_x0, 'o-', label='试验组真实数据')
    plt.plot(test_year, result1, '*-', label='GM(1,1) 预测结果')
    plt.grid(True)
    plt.xticks(np.arange(test_year[0], test_year[-1] + 1))
    plt.xlabel('x'); plt.ylabel('y')
    plt.legend(loc='best')
    plt.title('试验组:真实 vs 预测')

    plt.show()


def test(x0,year):

    predict_num = 5
    result, x0_hat, relative_residuals, eta = gm11(x0, predict_num)


    # 相对残差与级比偏差图
    plt.figure(4)
    plt.subplot(2, 1, 1)
    plt.plot(year[1:], relative_residuals, '*-')
    plt.grid(True); plt.legend(['相对残差'], loc='best'); plt.xlabel('年份')
    plt.xticks(year[1:])

    plt.subplot(2, 1, 2)
    plt.plot(year[1:], eta, 'o-')
    plt.grid(True); plt.legend(['级比偏差'], loc='best'); plt.xlabel('年份')
    plt.xticks(year[1:])


    # 残差检验
    average_relative_residuals = float(np.mean(relative_residuals))
    print(f'平均相对残差为 {average_relative_residuals:.2f}')
    if average_relative_residuals < 0.1:
        print('模型拟合程度非常不错')
    elif average_relative_residuals < 0.2:
        print('模型拟合程度达到一般要求')
    else:
        print('模型拟合程度不太好,建议使用其他模型')

    # 级比偏差检验
    average_eta = float(np.mean(eta))
    print(f'平均级比偏差为 {average_eta:2f}')
    if average_eta < 0.1:
        print('模型拟合程度非常不错')
    elif average_eta < 0.2:
        print('模型拟合程度达到一般要求')
    else:
        print('模型拟合程度不太好,建议使用其他模型')


    # 最终综合图
    plt.figure(5)
    plt.plot(year, x0, '-o', label='原始数据')
    plt.plot(year, x0_hat, '-*m', label='拟合数据')
    fut_year = np.arange(year[-1] + 1, year[-1] + 1 + predict_num)
    plt.plot(fut_year, result, '-*b', label='预测数据')
    # 连接最后一个已知点与首个预测点
    plt.plot([year[-1], fut_year[0]], [x0[-1], result[0]], '-*b')
    plt.grid(True)
    plt.xticks(np.arange(year[0], fut_year[-1] + 1))
    plt.xlabel('年份'); plt.ylabel('排污总量')
    plt.legend(loc='best')
    plt.title('GM(1,1) 拟合与预测')


    plt.show()
def main(x0,year):
    if np.any(x0 < 0):
        raise ValueError('输入数据不能小于0')
    if len(x0) <= 3:
        raise ValueError('输入数据长度不能小于3')
    if not check_input(x0):
        raise ValueError('输入数据不符合要求')

    train_val(x0,year)
    test(x0,year)

if __name__ == "__main__":
    year = np.arange(1995, 2005, 1, dtype=int)
    x0 = np.array([4,5,6,7,8,9,10,11,12,13], dtype=float)
    main(x0,year)