1.伯努利试验
我们做一个抛硬币的实验,假设硬币是均匀的
我们抛10次记做一组实验,第一组4正6反,第二组7正3反….
假设我们做了1000组实验,我们把每组结果得到的正面数量记录下来,共1000个数字,比如
4,6,5,7,5,9,4,5,6,1,…..
我们统计一下每个数字出现的频率,并画成柱状图
import random
import matplotlib.pyplot as plt
import numpy as np
import matplotlib.animation as animation


plt.rcParams["font.sans-serif"] = ["Microsoft YaHei"]
plt.rcParams["axes.unicode_minus"] = False


def board(rows, balls):

    positions = {}

    for _ in range(balls):
        num = 0

        for _ in range(rows):
            if random.random() < 0.5:  # 概率
                num += 1

        if num in positions:
            positions[num] += 1
        else:
            positions[num] = 1

    return positions


if __name__ == "__main__":
    rows = 10  # 投币次数
    balls = 1000  # 实验次数

    fig, ax = plt.subplots(figsize=(10, 6))

    ax.clear()
    positions = board(rows, balls)

    ax.bar(positions.keys(), positions.values(), color="skyblue", edgecolor="black")
    ax.set_title("投币实验", fontsize=16)
    ax.set_xlabel("正面次数", fontsize=12)
    ax.set_ylabel("组数", fontsize=12)
    ax.grid(True)
    plt.show()
得到结果图
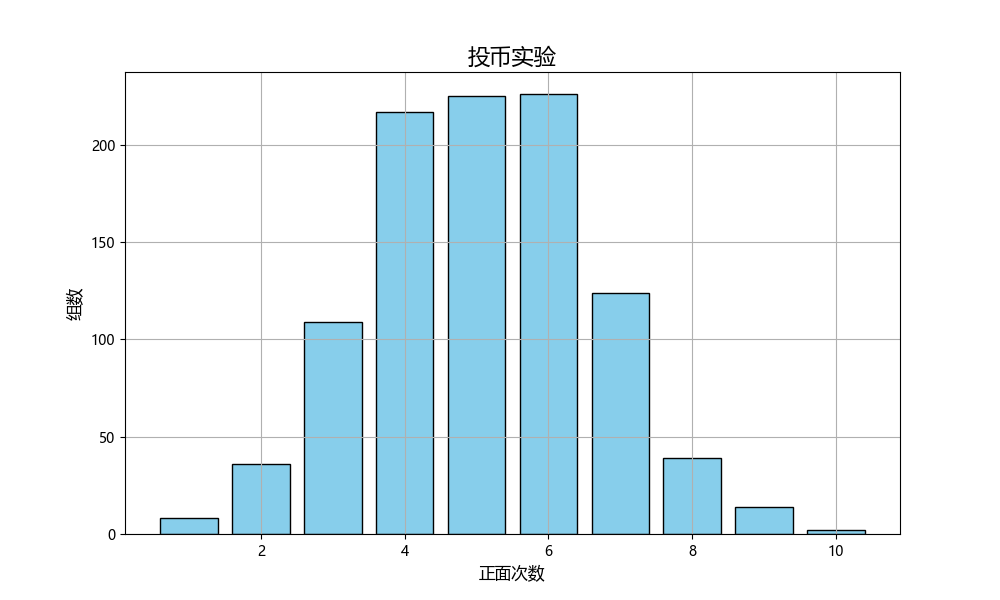
很像正态分布曲线
在概率学上,抛十次同一枚硬币的实验,叫做十重伯努利试验。
数学定理表明:大量的n重伯努利试验的结果能够产生正态曲线
事实上,可以用一个简易的装置来进行n重抛硬币实验,这个装置就是高尔顿板。
高尔顿板为一块竖直放置的板,上面有交错排列的钉子。让小球从板的上端自由下落,当其碰到钉子后会随机向左或向右落下。最终,小球会落至板底端的某一格子中。假设板上共有n排钉子,每个小球撞击钉子后向右落下的概率为p,则小球落入第k个格子概率为二项分布\(\begin{pmatrix}n\\k\end{pmatrix}p^k(1-p)^{n-k}\)
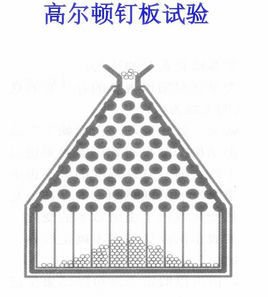
假设小球落到中间格n,说明向左的次数和向右的次数相同,如果落在n+1格,那么说明向右的次数比向左的次数多2次,以此类推
import random
import matplotlib.pyplot as plt
import numpy as np
import matplotlib.animation as animation


plt.rcParams["font.sans-serif"] = ["Microsoft YaHei"]
plt.rcParams["axes.unicode_minus"] = False


# 高尔顿板模拟函数
def galton_board(rows, balls, probs):

    positions = [0] * (rows*2 + 1)

    for _ in range(balls):
        position = rows

        for row in range(rows):
            if random.random() < probs[row]:  # 概率
                position += 1
            else:
                position -= 1

        position = max(0, min(position, rows*2))
        positions[position] += 1

    return positions


# 动画更新函数
def update(frame):
    ax.clear()
    positions = galton_board(rows, frame, probs)

    ax.bar(range(rows*2+1), positions, color="skyblue", edgecolor="black")
    ax.set_title("高尔顿板模拟", fontsize=16)
    ax.set_xlabel("位置", fontsize=12)
    ax.set_ylabel("球的数量", fontsize=12)
    ax.set_xticks(range(rows*2+1))
    ax.grid(True)


if __name__ == "__main__":
    rows = 10  # 行数
    balls = 15000  # 球的数量
    step = 5
    rand = False

    probs = [random.random() if rand else 0.5 for _ in range(rows)]

    print(f"概率分布为:{probs}")
    fig, ax = plt.subplots(figsize=(10, 6))

    ani = animation.FuncAnimation(
        fig, update, frames=np.arange(0, balls, balls//step), repeat=False
    )

    plt.show()
可以得到一个近似正太分布的曲线
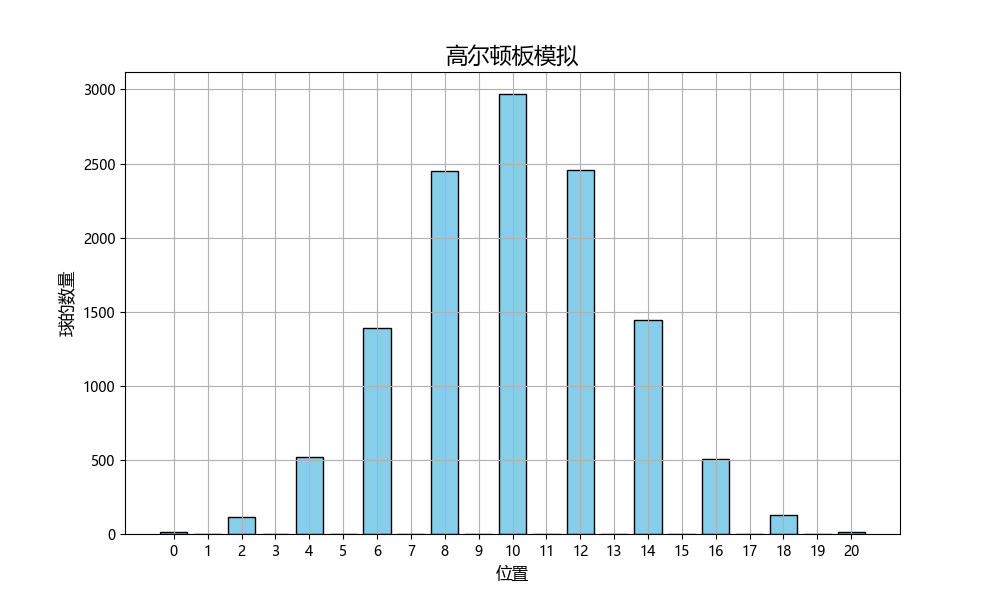
这是每一排概率都是0.5的结果,事实上,如果每一排概率都不一样,也能得到正态分布的曲线。在上面代码中,我们把rand = True
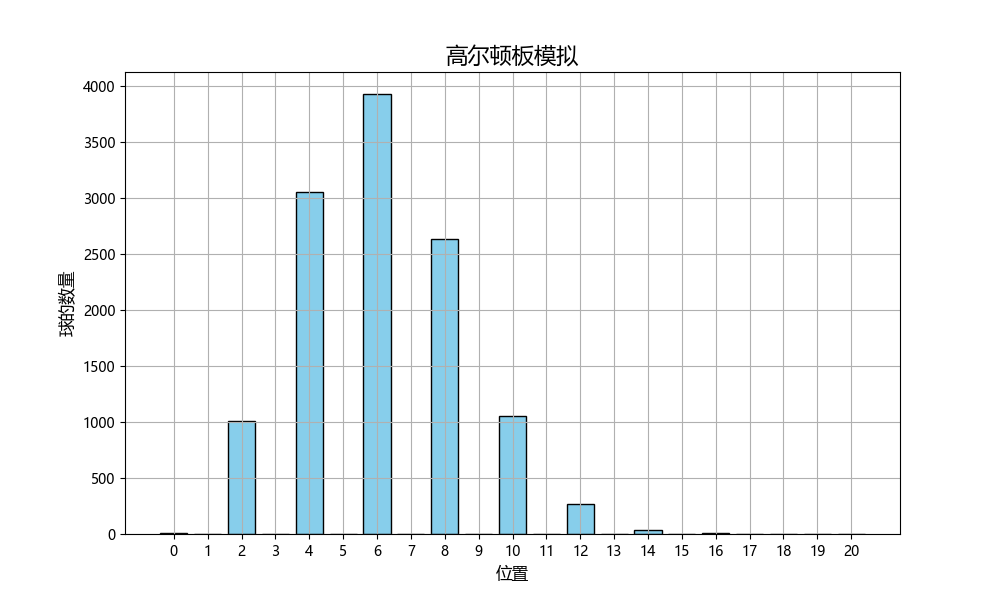
结果只是对称轴的位置有些差异,即便概率不同,在大量n重伯努利试验的概率分布仍然是正太分布
下面给出中心极限定理
数学表述为:所研究的随机变量如果由大量独立的随机变量相加而成,那么它的分布近似于正态分布
通俗表达:如果一个结果由大量的不相干的因素累加而成,那么这个结果一定表现为正态分布。
2.68-95-99法则
总体均值\(\mu=\frac{X_1+X_2+...+X_N}{N}\)
总体方差\(\sigma^2=\frac{(x_1-\mu)^2+(x_2-\mu)^2+...+(x_N-\mu)^2}{N}\)
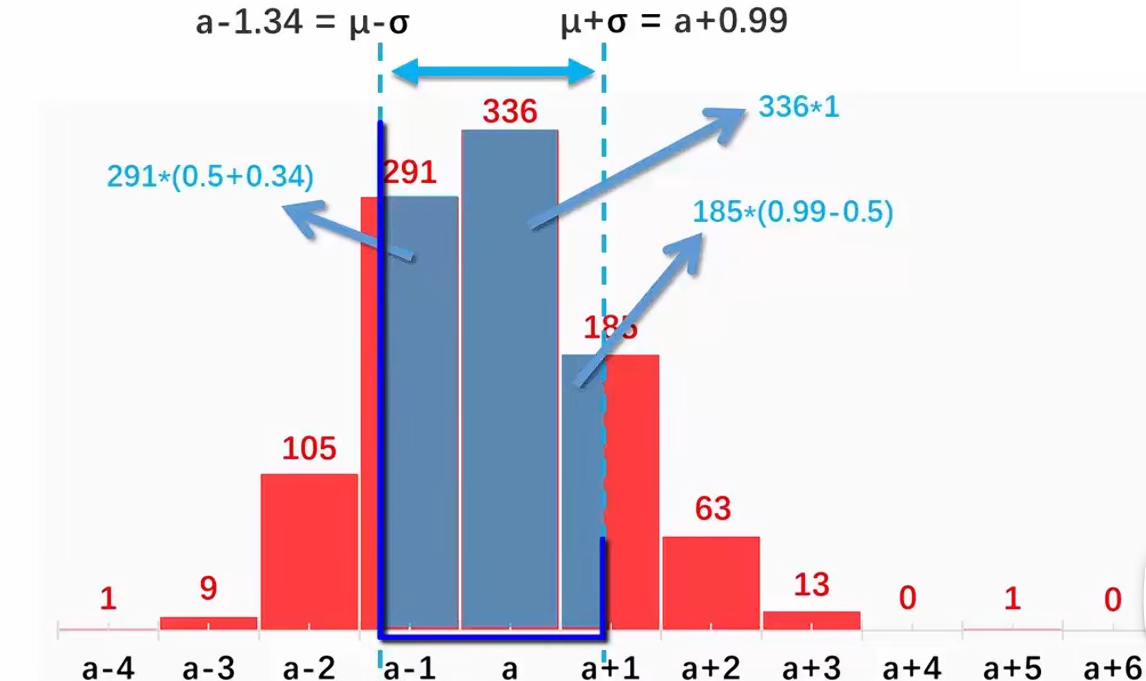
还是高尔顿板,假设我们算出了方差和均值。然后我们可以定义一个区间[\(\mu-\sigma\),\(\mu+\sigma\)],假设\(\mu-\sigma=a-1.34\),\(\mu+\sigma=a+0.99\)
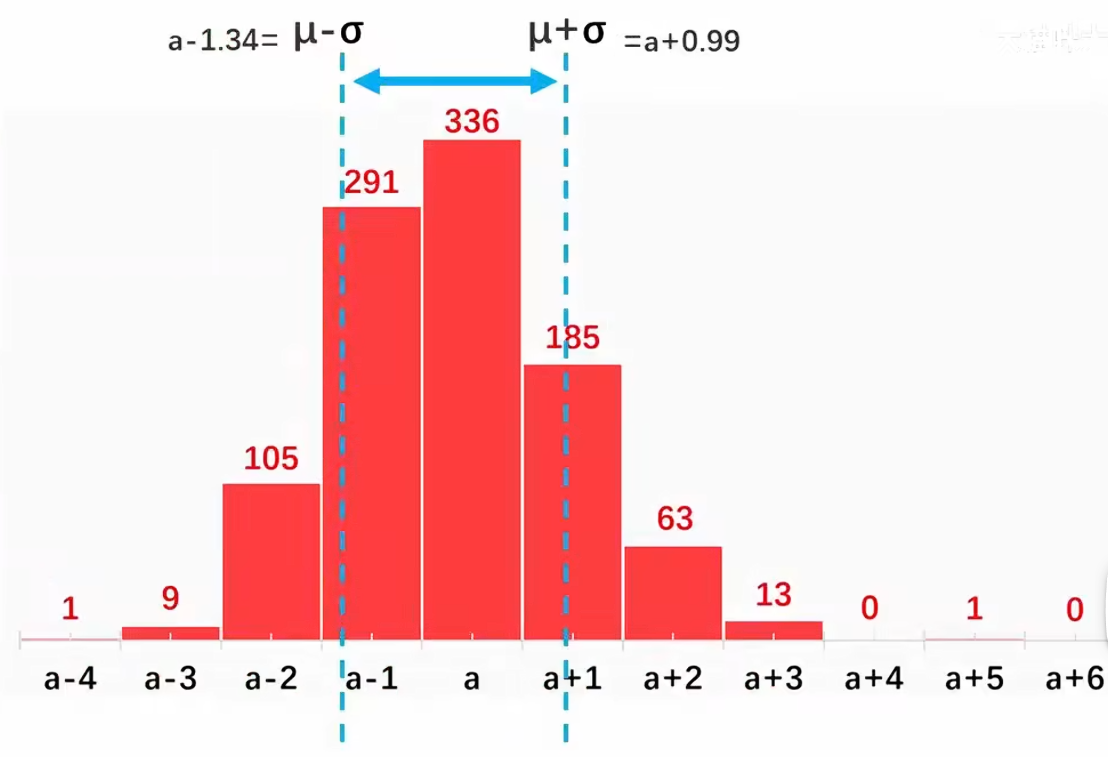
那么我们可以近似出这个区间的豆子数量,约670颗,占总体的67%左右
同理,我们定义一个\(2\sigma\)区间[\(\mu-2\sigma\),\(\mu+2\sigma\)]
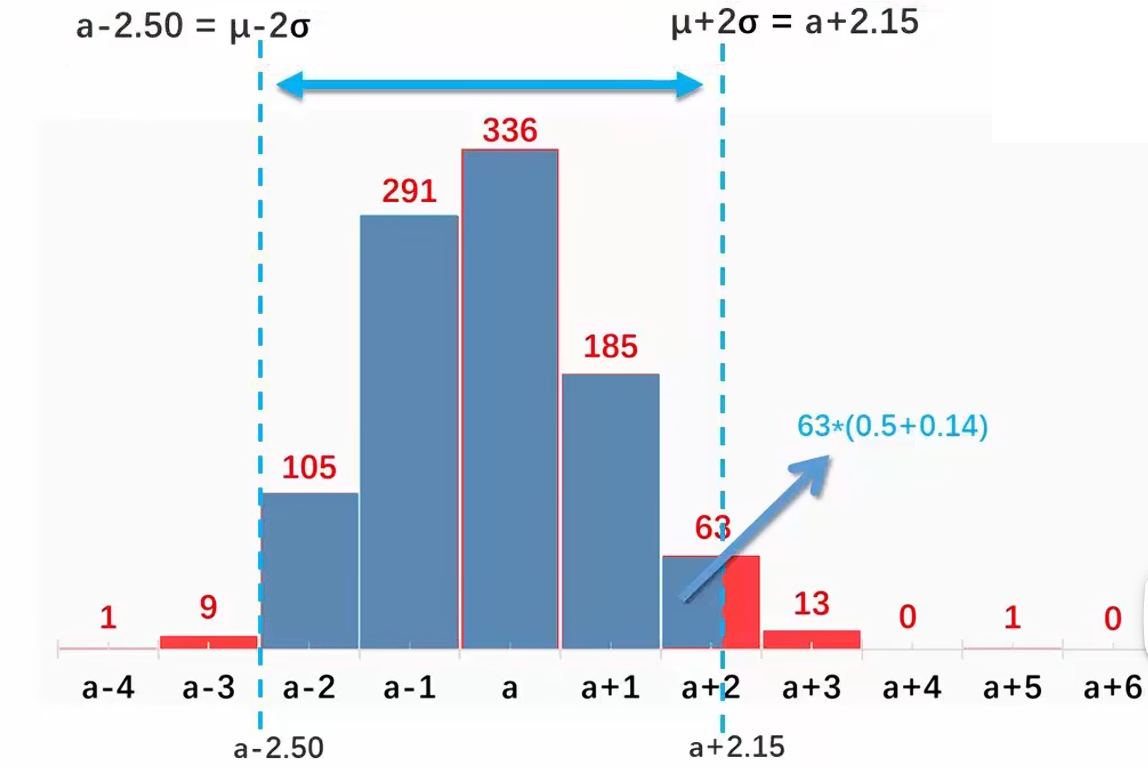
可以算出区间内有967颗豆子,占总体的95.7%
同理,定义一个\(3\sigma\)区间[\(\mu-3\sigma\),\(\mu+3\sigma\)]
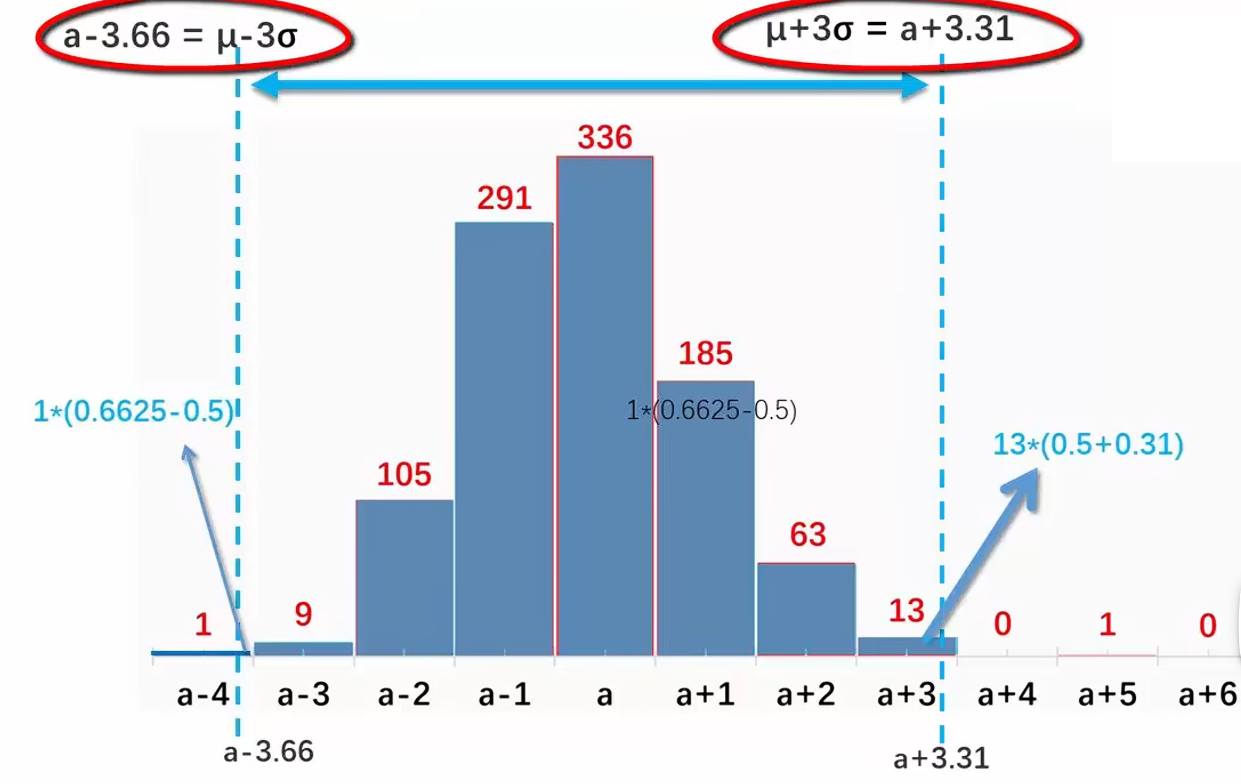
共999颗豆子,占总体的99.9%
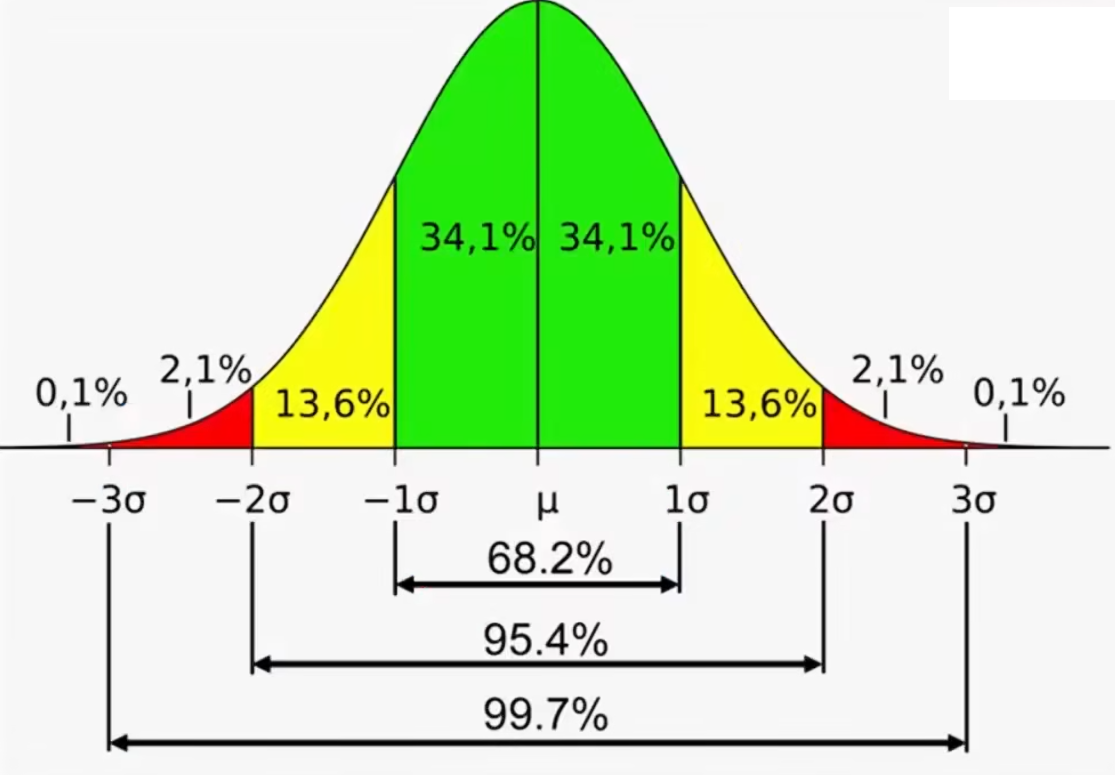
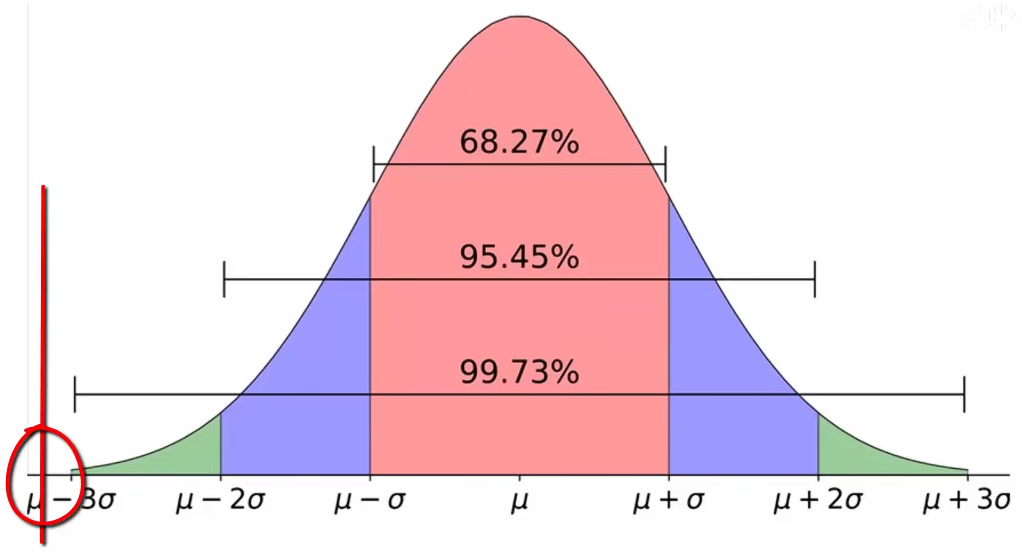
从大量的案例可以发现,若总体一个服从正态分布,不论其标准差是多少,以均值为中心,都有
- \(1\sigma\)区间覆盖总体的68.2%的样本
- \(2\sigma\)区间覆盖总体的95.4%的样本
- \(3\sigma\)区间覆盖总体的99.7%的样本
这就是68-95-99.7法则
3.均值抽样分布
假设我们要估计某一种情况的平均值,比如人口身高,但是我们不可能拿到所有中国人的数据。这时候,该怎么办?
答案是,我们可以做抽样,就是从总体中,抽取一些个体,抽取的个体数量N,叫做样本容量
我们可以计算这个样本的平均值,用来估计总体的平均值\(\mu\)
模拟代码如下
import matplotlib.pyplot as plt
import numpy as np


plt.rcParams["font.sans-serif"] = ["Microsoft YaHei"]
plt.rcParams["axes.unicode_minus"] = False

np.random.randint

# 模拟采样的
def sample_N(N):
    # 均匀分布
    data1 = np.random.uniform(0, 10, N)

    # 正态分布
    data2 = np.random.normal(0, 10, N)

    # 泊松分布
    data3 = np.random.poisson(5, N)

    # 指数分布
    data4 = np.random.exponential(2, N)

    # 二项分布
    data5 = np.random.binomial(10, 0.5, N)

    # 随机组合
    data = data1+data3*np.log(data4)-data5*np.abs(data2)

    return data

def board(total,N):
    res = {}
    datas = {}
    for _ in range(total):
        data = sample_N(N) #均值抽样

        for i in data:
            i = round(i)
            if i not in datas:
                datas[i]=0
            datas[i]+=1

        num = round(np.mean(data))
        if num not in res:
            res[num] = 0
        res[num] += 1

    return res,datas


if __name__ == "__main__":
    total = 10000  # 抽样次数
    N = 30  # 样本容量

    res,datas = board(total, N)


    plt.figure(1)
    plt.bar(res.keys(), res.values(), color="skyblue", edgecolor="black")
    plt.title("抽样分布", fontsize=16)
    plt.xlabel("x", fontsize=12)
    plt.ylabel("y", fontsize=12)
    plt.grid(True)

    plt.figure(2)
    plt.bar(datas.keys(), datas.values(), color="skyblue", edgecolor="black")
    plt.title("数据分布", fontsize=16)
    plt.xlabel("x", fontsize=12)
    plt.ylabel("y", fontsize=12)

    plt.grid(True)
    plt.show()
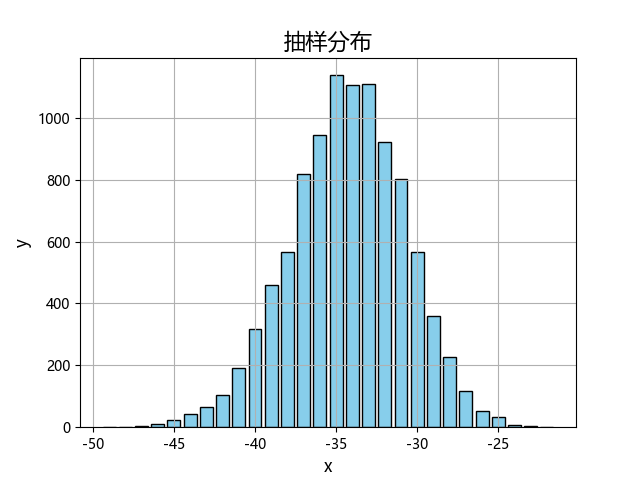
我们用了多种原始的数据分布的组合去生成一个未知的数据分布
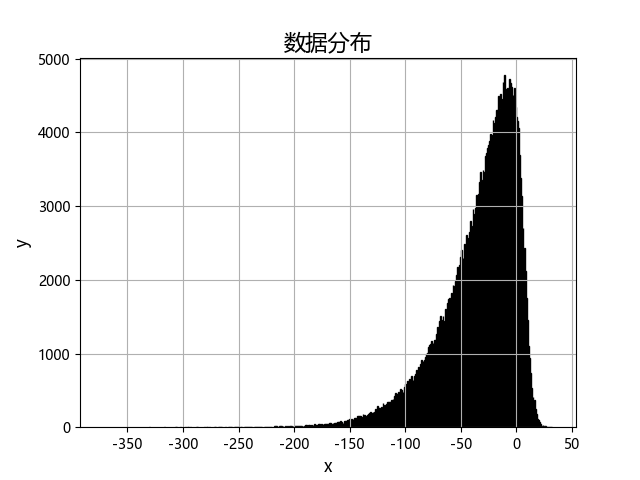
下图所示,这里样本容量N=30,可以发现,只要抽样次数足够多,容量N足够大,就能得到一个正态分布轮廓的均值抽样分布,而这个分布的对称轴必然是总体均值的真实值\(\mu\)。
(模拟方法:我们可以用sample_N提前生成一个大量数据的数组,然后从这个固定数组中反复抽样。最终抽样分布的对称轴必定接近数组的平均值)
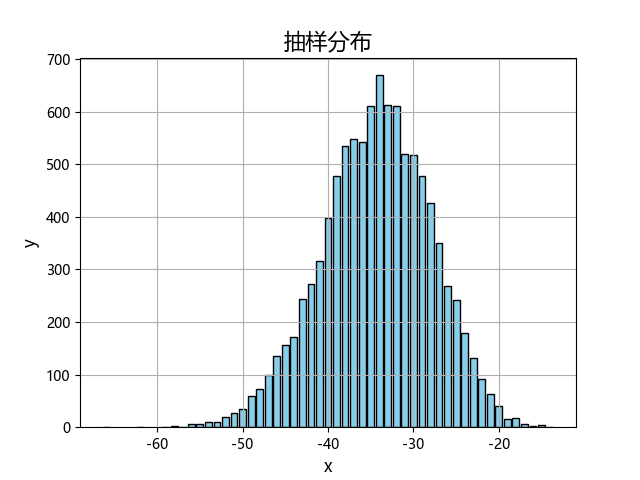
如果我们缩小N,比如N=5,可以发现分布变宽了
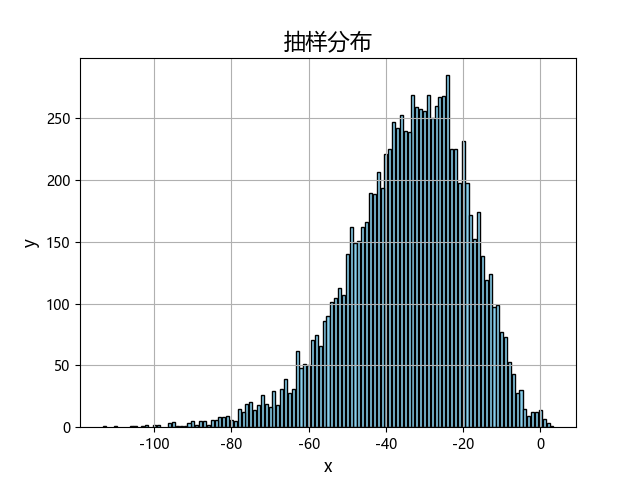
加大N=100,可以发现分布变窄了
下面给出均值抽样分布的中心极限定理
对一个总体进行大量重复的随机抽样并计算均值,用柱状图来表示这些均值出现的频次,最终将近似出正态分布的轮廓。正态分布对称轴所表示的值即为总体的真实均值,抽样的样本容量N越大则均值分布越窄(方差变小),抽样次数越多则直方图越平滑
在现实中,比如某国的平均收入是\(\mu\),标准差是\(\sigma\)。假设我们想知道我国的平均收入是否和这个分布差别不大。我们可以做一次采样,随机抽取 n 个观测值并计算样本均值 \(\bar{x}\),如果这仅仅一次的结果就位于\(3\sigma\)区间之外,我们有很大理由怀疑,我国的平均收入分布不属于均值为\(\mu\)的总体(不严谨)。
4.假设检验
假设有一个高一数学成绩的抽样分布如下图,每一个柱子的大小转为了百分比,代表占样本总体的比例
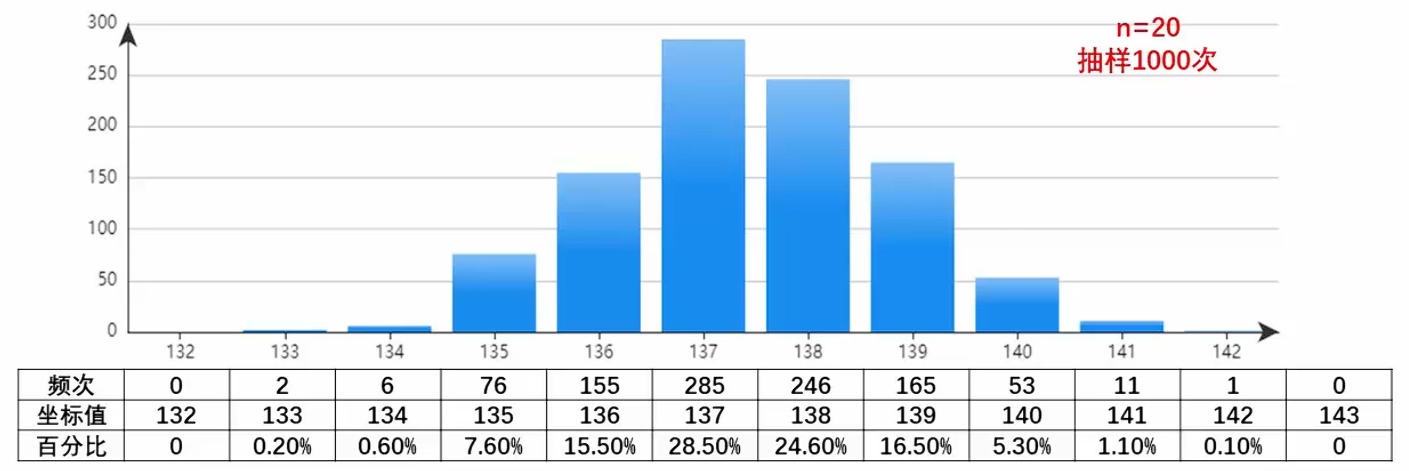
可以看出,样本均值落到两边尾巴的概率是非常低的,尾巴尖就代表是极端事件,那么如何界定是否是尾巴尖?其实就是频次小于某个数值,这个数值,叫做临界值,是一个人为规定的数值。
例如,人为规定,从两边尾巴尖项对称轴的方向,数出5%的频次的就是极端情况(其实就是\(2\sigma\))。如上图,从左边数到134共0.8%的,从右边数到141共1.2%。(再往中间数就超过5%了,所以不会继续数)
也就是说均值\(<=134或者>=141\)就是极端区域
假设高二数学成绩和高一数学总体是一样的,都是\(\mu=137.41\)的总体。我们在高二中进行一次抽样,得到样本均值为134,很明显落入了极端区域,极端事件发生,说明我们这个假设是有问题的。
下面给出定义
我们把一开始这个假设记作\(H_0\)
\(H_0\):高一数学成绩和高二数学成绩没有明显差别
\(H_0\):为零假设、原假设或Null Hypothesis
\(H_0\):\(\mu_{高一}=\mu_{高二}\)
\(H_1\):高一数学成绩和高二数学成绩有明显差别
在人为规定双边尾巴为5%,只抽样了一次,极端事件就发生了,我们便有理由拒绝\(H_0\),接受\(H_0\)的对立面假设\(H_1\),\(H_1\)也叫做对立假设、备择假设或Alternative Hypothesis。
这个双边尾巴5%,我们简化一下说法,叫做显著性水平\(\alpha\),英文是signification level,这个\(\alpha\)可以5%、2%或0.1%等,具体看实际案例,上面\(\alpha=5\%\),也就是两边各分配2.5%。
如果我们重新设置\(\alpha=0.1%\)%,那么,133-134就不是极端区域。那我们就不能拒绝\(H_0\),。这个“极端区域”有个专业的名字,英文为rejection region,中文为拒绝域、否定域或临界域
上述就是假设检验的基本思路。