requests
基本使用
import requests

url = 'http://www.example.com'
r = requests.get(url,timeout=5)  # 最好指定超时时间
常用属性
r.text:以字符串形式返回网页内容(默认编码,可能乱码)r.content:以字节形式返回响应内容from PIL import Image from io import BytesIO i = Image.open(BytesIO(r.content))r.encoding:设置编码格式,例如 r.encoding = ‘utf-8’r.url:返回请求的最终 URLr.status_code:返回响应状态码(200 表示成功)r.headers:返回响应头信息(字典类型)
get请求
import requests

url = 'https://www.example.com'
headers = {
    'User-Agent': 'Mozilla/5.0'
}
params = {
    'key': 'value'
}

r = requests.get(url, params=params, headers=headers)
r.encoding = 'utf-8'
print(r.text)
post请求
import requests
import json

url = 'https://www.example.com'
headers = {
    'User-Agent': 'Mozilla/5.0'
}
data = {
    'key': 'value'
}

r = requests.post(url, data=data, headers=headers)
result = json.loads(r.text)
print(result)
设置代理
import requests

url = 'https://www.baidu.com/s'
headers = {
    'User-Agent': 'Mozilla/5.0'
}
params = {
    'wd': 'ip'
}
proxies = {
    'http': 'http://218.14.108.53'
}

r = requests.get(url, params=params, headers=headers, proxies=proxies)
print(r.text)
Session
Session让你能够跨请求保持某些参数。它也会在同一个 Session 实例发出的所有请求之间保持 cookie。如果向同一主机发送多个请求,底层的 TCP 连接将会被重用,从而带来显著的性能提升。
s = requests.Session()

s.get('http://httpbin.org/cookies/set/sessioncookie/123456789')
r = s.get("http://httpbin.org/cookies")

print(r.text)
# '{"cookies": {"sessioncookie": "123456789"}}'
xpath
用法
from lxml import etree

tree = etree.parse('new.html')

li_list = tree.xpath('//body//li')
语法
| 表达式 | 描述 |
|---|---|
nodename |
选取此节点的所有子节点。 |
/ |
从根节点选取(取子节点)。 |
// |
从匹配选择的当前节点选择文档中的节点,而不考虑它们的位置(取子孙节点)。 |
. |
选取当前节点。 |
.. |
选取当前节点的父节点。 |
@ |
选取属性。 |
| 路径表达式 | 结果 |
|---|---|
bookstore |
选取所有名为 bookstore 的节点。 |
/bookstore |
选取根元素 bookstore。注释:路径起始于
/ 时,始终代表到某元素的绝对路径! |
bookstore/book |
选取属于 bookstore 的子元素的所有 book 元素。 |
//book |
选取所有 book 子元素,而不管它们在文档中的位置。 |
bookstore//book |
选择属于 bookstore 元素的后代的所有 book 元素,而不管它们位于 bookstore 之下的什么位置。 |
//@lang |
选取名为 lang 的所有属性。 |
通配符说明表
| 通配符 | 描述 |
|---|---|
* |
匹配任何元素节点。 |
@* |
匹配任何属性节点。 |
node() |
匹配任何类型的节点。 |
/bookstore/* |
选取 bookstore 元素的所有子元素。 |
//* |
选取文档中的所有元素。 |
//title[@*] |
选取所有带有属性的 title 元素。 |
特殊函数
| 路径表达式 | 结果 |
|---|---|
/bookstore/book[1] |
选取属于 bookstore 子元素的第一个 book 元素。 |
/bookstore/book[last()] |
选取属于 bookstore 子元素的最后一个 book 元素。 |
/bookstore/book[last()-1] |
选取属于 bookstore 子元素的倒数第二个 book 元素。 |
/bookstore/book[position()<3] |
选取最前面的两个属于 bookstore 元素的子元素的 book 元素。 |
//title[@lang] |
选取所有拥有名为 lang 的属性的 title 元素。 |
//title[@lang='eng'] |
选取所有 title 元素,且这些元素拥有值为 eng 的 lang 属性。 |
/bookstore/book[price>35.00] |
选取 bookstore 元素的所有 book 元素,且其中的 price 元素的值须大于 35.00。 |
/bookstore/book/text() |
选取 bookstore 元素的所有 book 元素的文本内容。 |
//ul/li[starts-with(@id,"c")]/text() |
选取所有 id 属性值以 c 开头的 li 元素的文本内容。 |
//ul/li[@id = "l1" and @ class = "c1"]/text() |
选取 id 属性值为 l1 且 class 属性值为 c1 的 li 元素的文本内容。 |
//ul/li[contains(@id,"l")]/text() |
选取所有 id 属性值包含 l 的 li 元素的文本内容。 |
//book/title \| //book/price |
选取 book 元素的所有 title 和 price 元素。 |
jsonpath
与xpath差异
| XPath | JSONPath | 描述 |
|---|---|---|
| / | $ | 根元素 |
| . | @ | 当前元素 |
| / | . or [] | 当前元素的子元素 |
| .. | n/a | 当前元素的父元素 |
| // | .. | 当前元素的子孙元素 |
| * | * | 通配符 |
| @ | n/a | 属性的访问字符 |
jsonpath用法
{
    "store": {
        "book": [
            {
                "category": "reference",
                "author": "Nigel Rees",
                "title": "Sayings of the Century",
                "price": 8.95
            },
            {
                "category": "fiction",
                "author": "Evelyn Waugh",
                "title": "Sword of Honour",
                "price": 12.99
            },
            {
                "category": "fiction",
                "author": "Herman Melville",
                "title": "Moby Dick",
                "isbn": "0-553-21311-3",
                "price": 8.99
            },
            {
                "category": "fiction",
                "author": "J. R. R. Tolkien",
                "title": "The Lord of the Rings",
                "isbn": "0-395-19395-8",
                "price": 22.99
            }
        ],
        "bicycle": {
            "author": "Tony",
            "color": "red",
            "price": 19.95
        }
    },
    "expensive": 10
}
import json
import jsonpath
obj = json.load(open('store.json','r',encoding = 'utf-8'))
book_author_list = jsonpath.jsonpath(obj,'$.store.book[*].author')
author = jsonpath.jsonpath(obj,'$.store.book[1].author')
author_list = jsonpath.jsonpath(obj,'$..author')
tag_list = jsonpath.jsonpath(obj,'$.store.*')
price_list = jsonpath.jsonpath(obj,'$.store..price')
book = jsonpath.jsonpath(obj,'$.store.book[2]')
last_book = jsonpath.jsonpath(obj,'$..book[(@.length-1)]')
book_list = jsonpath.jsonpath(obj,'$..book[0,1]')
book_list = jsonpath.jsonpath(obj,'$..book[:2]')
book_list = jsonpath.jsonpath(obj,'$..book[?(@.isbn)]')
book_list = jsonpath.jsonpath(obj,'$..book[?(@.price > 10)]')bs4
bs4 用法
主要是用前端css方法锁定
from bs4 import BeautifulSoup

soup = BeautifulSoup(open("soup.html", encoding="utf-8"), "lxml")

soup.find("a")
soup.find("a", title="s2")
soup.find("a", class_="a1")
soup.find_all("a")
soup.find_all(["a", "span"])
soup.find_all("li", limit=2)
soup.select("a")
soup.select(".s1")
soup.select("#s2")
soup.select("li[id]")
soup.select('li[id = "l2"]')
soup.select("div li")
soup.select("div > ul > li")
soup.select("a,li")

obj = soup.select("#s2")[0]
obj.get_text()
tag = soup.select("#s2")[0]
tag.name
tag.attrs
tag.attrs.get("title")
scrapy
命令行
在 project_dir 目录下创建一个 Scrapy 项目。如果未指定 project_dir,则 project_dir 将与 project_name 相同
scrapy startproject <project_name> [project_dir]创建一个新的爬虫
scrapy genspider <spider> <domain>运行爬虫
scrapy crawl <spider>实战
bangumi
定义爬取逻辑
下面创建的scrapy_learn项目的文件夹结构如下: 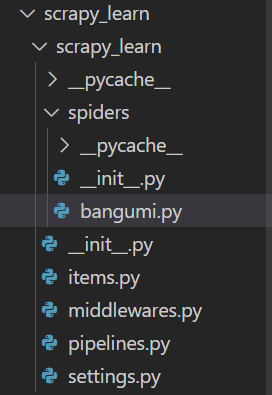 这边我们对
bangumi网站进行爬取,
- 在Spiders文件夹下,bangumi.py文件是爬虫的核心文件,后续的大部分代码都会写入这个文件,因此它是至关重要的py文件。
- items.py文件:这文件定义了数据结构,这里的数据结构与算法中的数据结构不同,它指的是爬虫目标数据的数据组成结构,例如我们需要获取目标网页的图片和图片的名称,那么此时我们的数据组成结构就定义为 图片、图片名称。
- middleware.py文件:这文件包含了scrapy项目的一些中间构件,例如代理、请求方式、执行等等,它对于项目来说是重要的,但对于爬虫基础学习来说,可以暂时不考虑更改它的内容。
- pipelines.py文件:这是我们之前在工作原理中提到的scrapy框架中的管道文件,管道的作用是执行一些文件的下载,例如图片等。
- settings.py文件:这文件是整个scrapy项目的配置文件,例如ROBOTS协议限制,就需要进入该文件解除该限制,否则将无法实现爬取。
首先要定义爬虫的解析逻辑, bangumi.py代码如下
class BangumiSpider(scrapy.Spider):
    name = "bangumi"
    allowed_domains = ["bangumi.tv"]
    start_urls = ["https://bangumi.tv/anime/browser/?sort=rank&page=1"]


    def parse(self, response):
        data = response.xpath("//ul[@id='browserItemList']/li")
        for item in data:
            chName = item.xpath(".//div/h3/a/text()").extract_first()
            href = item.xpath(".//div/h3/a/@href").extract_first()
            oriName = item.xpath(".//div/h3/small/text()").extract_first()
            info = item.xpath(".//div/p[@class='info tip']/text()").extract_first().strip()
            imgUrl = item.xpath('.//a/span[@class="image"]/img/@src').extract_first()
创建类的时候,有3个基本参数和parse函数,name是爬虫的名字,allowed_domains是爬取的域名,start_urls是爬取的url。
- allowed_domains:规定爬取的url的范围,我们只能在这个参数定义的url的范围下获取数据,一旦数据超出范围,那么我们的请求将会失效。
- start_urls:框架起始访问的url,也即在最初向这个url的位置发起请求。
- parse函数:这个函数是爬虫的核心函数,当框架向
start\_urls发起请求后,就会调用这个函数,这个函数就是用来解析数据,解析数据后,框架会自动将数据交给pipelines进行下载。
parse函数的response参数有三种常用方法:
response.xpath(xpath语句传入):这种方式是对response进行xpath解析,我们在括号内传入xpath语法对应的语句即可,要注意的是,普通的xpath解析,返回的是一个列表,但是在scrapy框架中的xpath解析,返回的是selector对象列表,针对selector对象列表,我们需要进一步的处理,才能真正拿到数据。
response.extract():这种处理,承接了上面的操作,当我们拿到了selector对象列表,通过再执行.extract()函数,即可把selector对象列表转成普通的列表,进而获取数据。
response.extract_first():这是第二种方法的加强版本,可以直接拿到转成的普通列表的第一个元素,在一些情况下更方便。
数据结构和piplines
如果对数据做进一步的操作,则需要定义一个继承scrapy.Item类,items.py代码如下:
class ScrapyBangumiItem(scrapy.Item):
    chName = scrapy.Field()
    oriName= scrapy.Field()
    info = scrapy.Field()
    href = scrapy.Field()
    imgUrl = scrapy.Field()
之后在parse函数中,我们导入这个类,并把解析到的数据赋值给这个对象,并传给pipelines进行处理。
class BangumiSpider(scrapy.Spider):
    。。。
    def parse(self, response):
        data = response.xpath("//ul[@id='browserItemList']/li")
        for item in data:
            chName = item.xpath(".//div/h3/a/text()").extract_first()
            href = item.xpath(".//div/h3/a/@href").extract_first()
            oriName = item.xpath(".//div/h3/small/text()").extract_first()
            info = item.xpath(".//div/p[@class='info tip']/text()").extract_first().strip()
            imgUrl = item.xpath('.//a/span[@class="image"]/img/@src').extract_first()
            bangumiItem = ScrapyBangumiItem(chName=chName, oriName=oriName, info=info,href=href,imgUrl=imgUrl)

            yield bangumiItem
yield bangumiItem
是一个生成器函数,当调用yield时,框架会自动将数据交给piplines进行处理。
我们在piplines.py
定义后续的逻辑,可以做保存,下载等操作
class ScrapyLearnPipeline:
    def process_item(self, item, spider):
        self.fp.write(str(item) + "\n")

    def open_spider(self, spider):
        self.fp = open("result.json", "w", encoding="utf-8")

    def close_spider(self, spider):
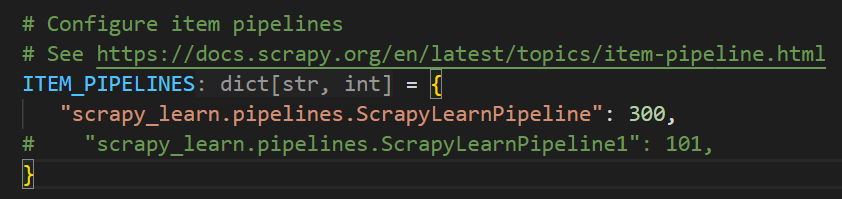
self.fp.close()这个类不用继承任何父类,只需要实现process_item方法即可,然后在在settings.py中定义这个类,即可实现对数据的保存。
open_spider和close_spider
是可选方法,这是框架自带的,当爬虫启动时,会调用open_spider方法,当爬虫关闭时,会调用close_spider方法。
我们可以定义多个piplines,然后在settings.py中导入即可,还需要定义优先级,默认为300,数字越大,优先级越低。
多url下载
在爬取多个url时,有两种方式:
- 在
start_urls中定义多个url,框架会自动进行并发请求,并把结果交给piplines进行处理。 - 在parse函数中,使用
scrapy.Request方法,对每个url进行请求,并把结果交给piplines进行处理。
第二种方法属于可以自定义哪些url进行请求,这样我们可以实现多url的下载。
下面是完整代码:
class BangumiSpider(scrapy.Spider):
    name = "bangumi"
    allowed_domains = ["bangumi.tv"]
    start_urls = ["https://bangumi.tv/anime/browser/?sort=rank&page=1"]
    base_url = "https://bangumi.tv/anime/browser/?sort=rank&page="
    page = 1
    def parse(self, response):
        data = response.xpath("//ul[@id='browserItemList']/li")
        for item in data:
            chName = item.xpath(".//div/h3/a/text()").extract_first()
            href = item.xpath(".//div/h3/a/@href").extract_first()
            oriName = item.xpath(".//div/h3/small/text()").extract_first()
            info = item.xpath(".//div/p[@class='info tip']/text()").extract_first().strip()
            imgUrl = item.xpath('.//a/span[@class="image"]/img/@src').extract_first()
            bangumiItem = ScrapyBangumiItem(chName=chName, oriName=oriName, info=info,href=href,imgUrl=imgUrl)

            yield bangumiItem


        if self.page<5:
            self.page+=1
            url = self.base_url+str(self.page)
            yield scrapy.Request(url=url,callback=self.parse)
yield scrapy.Request(url=url,callback=self.parse) 中
callback=self.parse
是指当请求完成后,会调用parse函数,从而实现多url的下载。
setting
修改日志级别,它的格式是这样的:
LOG_LEVEL = '对应级别的大写英文'| 日志级别 | 中文解释 |
|---|---|
| ERROR | 一般错误 |
| WARNING | 警告 |
| INFO | 一般的信息 |
| DEBUG | 调试信息 |
可以定义日志保存的文件路径,格式如下:
LOG_FILE = 'xxxx.log'资源
httpbin.org https://api.github.com/events