机器学习
1. 基本
机器学习的方法一般主要由三部分构成:模型、策略和算法,可以认为:
机器学习方法 =模型 +策略 +算法
模型:总结数据的内在规律,用数学语言描述的参数系统
策略:选取最优模型的评价准则
算法:选取最优模型的具体方法
2.特征工程
特征工程(Feature Engineering)是机器学习过程中非常重要的一步,指的是通过对原始数据的处理、转换和构造,生成新的特征或选择有效的特征,从而提高模型的性能。简单来说,特征工程是将原始数据转换为可以更好地表示问题的特征形式,帮助模型更好地理解和学习数据中的规律。优秀的特征工程可以显著提高模型的表现;反之,忽视特征工程可能导致模型性能欠佳。
实际上,特征工程是一个迭代过程。特征工程取决于具体情境。它需要大量的数据分析和领域知识。其中的原因在于,特征的有效编码可由所用的模型类型、预测变量与输出之间的关系以及模型要解决的问题来确定。在此基础上,辅以不同类型的数据集(如文本与图像)则可能更适合不同的特征工程技术。因此,要具体说明如何在给定的机器学习算法中最好地实施特征工程可能并非易事。
2.1 生成特征的方向
2.1.1特征选择
从原始特征中挑选出与目标变量关系最密切的特征,剔除冗余、无关或噪声特征。这样可以减少模型的复杂度、加速训练过程、并减少过拟合的风险。
特征选择不会创建新特征,也不会改变数据结构。
(1)过滤法
基于统计测试(如卡方检验、相关系数、信息增益等)来评估特征与目标变量之间的关系,选择最相关的特征。
(2)包裹法
使用模型(如递归特征消除 RFE)来评估特征的重要性,并根据模型的表现进行特征选择。
(3)嵌入法
使用模型本身的特征选择机制(如决策树的特征重要性,L1正则化的特征选择)来选择最重要的特征。
2.1.2特征转换
对数据进行数学或统计处理,使其变得更加适合模型的输入要求。
(1)归一化(Normalization)
将特征缩放到特定的范围(通常是0到1之间)。适用于对尺度敏感的模型(如KNN、SVM)。
(2)标准化(Standardization)
通过减去均值并除以标准差,使特征的分布具有均值0,标准差1。
(3)对数变换
对于有偏态的分布(如收入、价格等),对数变换可以将其转化为更接近正态分布的形式。
(4)类别变量的编码
独热编码:将类别型变量转换为二进制列,常用于无序类别特征。
标签编码:将类别型变量映射为整数,常用于有序类别特征。
目标编码:将类别变量的每个类别替换为其对应目标变量的平均值或其他统计量。
频率编码:将类别变量的每个类别替换为该类别在数据集中的出现频率。
2.1.3特征构造
特征构造是基于现有的特征创造出新的、更有代表性的特征。通过组合、转换、或者聚合现有的特征,形成能够更好反映数据规律的特征。
(1)交互特征
将两个特征组合起来,形成新的特征。例如,两个特征的乘积、和或差等。
例如,将年龄与收入结合创建新的特征,可能能更好地反映某些模式。
(2)统计特征
从原始特征中提取统计值,例如求某个时间窗口的平均值、最大值、最小值、标准差等。
例如,在时间序列数据中,你可以从原始数据中提取每个小时、每日的平均值。
(3)日期和时间特征
从日期时间数据中提取如星期几、月份、年份、季度等特征。
例如,将“2000-01-01”转换为“星期几”、“是否节假日”、“月初或月末”等特征。
2.1.4特征降维
当数据集的特征数量非常大时,特征降维可以帮助减少计算复杂度并避免过拟合。通过降维方法,可以在保持数据本质的情况下减少特征的数量。
(1)主成分分析(PCA)
通过线性变换将原始特征映射到一个新的空间,使得新的特征(主成分)尽可能地保留数据的方差。
(2)线性判别分析(LDA)
一种监督学习的降维方法,通过最大化类间距离与类内距离的比率来降维。
(3)t-SNE(t分布随机近邻嵌入)
一种非线性的降维技术,特别适合可视化高维数据。
(4)自编码器(Auto Encoder)
一种神经网络模型,通过压缩编码器来实现数据的降维。
2.2 常用方法
对于一个模型来说,有些特征可能很关键,而有些特征可能用处不大。
例如:
某个特征取值较接近,变化很小,可能与结果无关。
某几个特征相关性较高,可能包含冗余信息。
因此,特征选择 在特征工程中是最基本、也最常见的操作。
另外,在训练模型时有时也会遇到维度灾难,即特征数量过多。我们希望能在确保不丢失重要特征的前提下减少维度的数量,来降低训练模型的难度。所以在特征工程中,也经常会用到 特征降维 方法。
2.2.1低方差过滤法
对于特征的选择,可以直接基于方差来判断,这是最简单的。低方差的特征意味着该特征的所有样本值几乎相同,对预测影响极小,可以将其去掉。
from sklearn.feature_selection import VarianceThreshold

# 低方差过滤:删除方差低于 0.01 的特征
var_thresh = VarianceThreshold(threshold=0.01)
X_filtered = var_thresh.fit_transform(X)
2.2.2相关系数法
通过计算特征与目标变量或特征之间的相关性,筛选出高相关性特征(与目标相关)或剔除冗余特征(特征间高度相关)。
(1)皮尔逊相关系数
皮尔逊相关系数(Pearson Correlation)用于衡量两个变量的线性相关性,取值范围。
\(r=\frac{\Sigma_i (x_i-\bar{x})(y_i-\bar{y})}{\sqrt{\Sigma_i(x_i-\bar{x})^2}\Sigma{y_i-\bar{y})^2}}\)
例如,现有一数据集包括不同渠道广告投放金额与销售额。
使用pandas.DataFrame.corrwith(method="pearson")计算各个特征与标签间的皮尔逊相关系数。
import pandas as pd

advertising = pd.read_csv("data/advertising.csv")
advertising.drop(advertising.columns[0], axis=1, inplace=True)
advertising.dropna(inplace=True)
X = advertising.drop("Sales", axis=1)
y = advertising["Sales"]
# 计算皮尔逊相关系数
print(X.corrwith(y, method="pearson"))
# TV           0.782224
# Radio        0.576223
# Newspaper    0.228299
# dtype: float64


import seaborn as sns
import matplotlib.pyplot as plt

# 计算皮尔逊相关系数矩阵
corr_matrix = advertising.corr(method="pearson")
# 可视化热力图
sns.heatmap(corr_matrix, annot=True, cmap="coolwarm", fmt=".2f")
plt.title("Feature Correlation Matrix")
plt.show()
(2)斯皮尔曼相关系数
斯皮尔曼相关系数的定义是等级变量之间的皮尔逊相关系数。用于衡量两个变量之间的单调关系,即当一个变量增加时,另一个变量是否总是增加或减少(不要求是线性关系)。适用于非线性关系或数据不符合正态分布的情况。
\(r_s=1-\frac{6\Sigma d_i^2}{n(n^2-1)}\)
其中:
d 是两个变量的等级之差
n 是样本数
斯皮尔曼相关系数的取值范围为[-1,1]
例如,现有一组每周学习时长与数学考试成绩的数据:
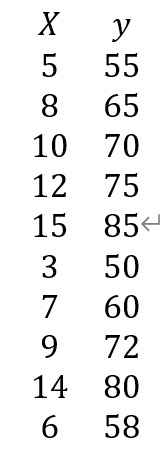
按数值由小到大排出x,y的等级,并计算等级差:
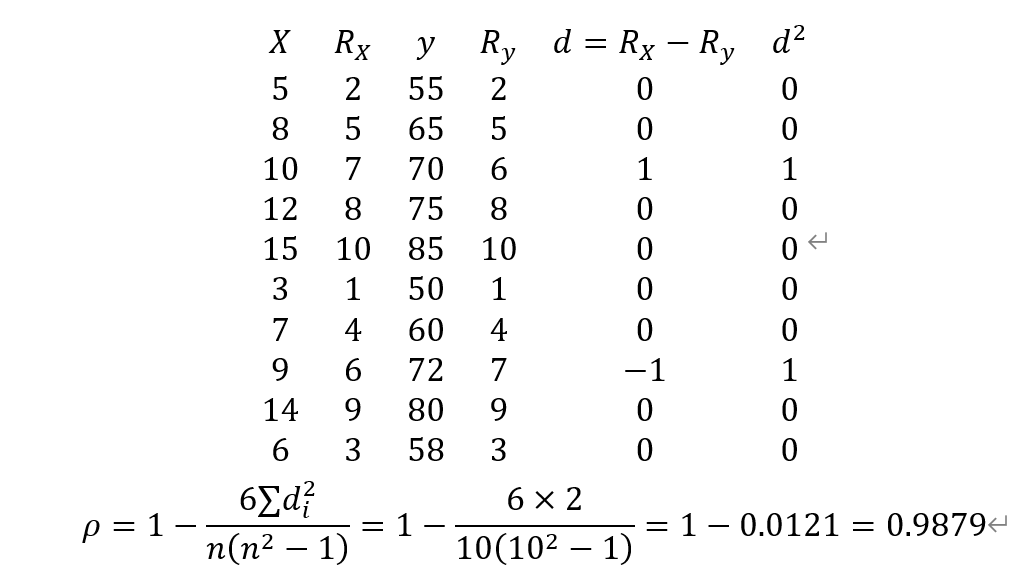
import pandas as pd

# 每周学习时长
X = [[5], [8], [10], [12], [15], [3], [7], [9], [14], [6]]
# 数学考试成绩
y = [55, 65, 70, 75, 85, 50, 60, 72, 80, 58]
# 计算斯皮尔曼相关系数
X = pd.DataFrame(X)
y = pd.Series(y)
print(X.corrwith(y, method="spearman"))
# 0.987879
2.2.3主成分分析(PCA)
主成分分析(Principal Component Analysis,PCA)是一种常用的降维技术,通过线性变换将高维数据投影到低维空间,同时保留数据的主要变化模式。
import numpy as np
import matplotlib.pyplot as plt
from sklearn.decomposition import PCA
from sklearn.preprocessing import StandardScaler

n_samples = 1000

component1 = np.random.normal(0, 1, n_samples)
component2 = np.random.normal(0, 0.2, n_samples)

noise = np.random.normal(0, 0.1, n_samples)
# 构造3维数据
X = np.vstack([component1 - component2, component1 + component2, component2 + noise]).T

# 标准化
scaler = StandardScaler()
X_standardized = scaler.fit_transform(X)

# 应用PCA,将3维数据降维到2维
pca = PCA(n_components=2)
X_pca = pca.fit_transform(X_standardized)

# 可视化
# 转换前的3维数据可视化
fig = plt.figure(figsize=(12, 4))
ax1 = fig.add_subplot(121, projection="3d")
ax1.scatter(X[:, 0], X[:, 1], X[:, 2], c="g")

ax1.set_title("Before PCA (3D)")
ax1.set_xlabel("Feature 1")
ax1.set_ylabel("Feature 2")
ax1.set_zlabel("Feature 3")
# 转换后的2维数据可视化
ax2 = fig.add_subplot(122)
ax2.scatter(X_pca[:, 0], X_pca[:, 1], c="g")
ax2.set_title("After PCA (2D)")
ax2.set_xlabel("Principal Component 1")
ax2.set_ylabel("Principal Component 2")
plt.show()
3. 入门案例
3.1 KNN工作原理
K近邻算法属于监督学习算法。其核心思想是通过计算给定样本与数据集中所有样本的距离,找到距离最近的K个样本,然后根据这K个样本的类别或值来预测当前样本的类别或值。
分类任务:统计K个近邻各类别的数量,将待分类样本归为数量最多的类别。
from sklearn.neighbors import KNeighborsClassifier

knn = KNeighborsClassifier(n_neighbors=2)  # KNN分类模型,K值为2
X = [[2, 1], [3, 1], [1, 4], [2, 6]]  # 特征
y = [0, 0, 1, 1]  # 标签
knn.fit(X, y)  # 模型训练
knn.predict([[4, 9]])  # 预测
回归任务:取K个近邻的平均值作为预测结果。
from sklearn.neighbors import KNeighborsRegressor

knn = KNeighborsRegressor(n_neighbors=2)  # KNN回归模型,K值为2
X = [[2, 1], [3, 1], [1, 4], [2, 6]]  # 特征
y = [0.5, 0.33, 4, 3]  # 标签
knn.fit(X, y)  # 模型训练
knn.predict([[4, 9]])  # 预测
3.2距离度量方法
欧式距离:\(d(x,y)=\sqrt{\Sigma_i(x_i-y_i)^2}\)
曼哈顿距离 \(d(x,y)=\Sigma_i|x_i-y_i|\)
切比雪夫距离 \(d(x,y)=max|x_i-y_i|\)
闵可夫斯基距离 \(d(x,y)=(\Sigma_i|x_i-y_i|^p)^{\frac{1}{p}}\)
3.3 归一化与标准化
3.3.1 归一化
1)定义
将数据按比例缩放到一个固定范围\([x_{min},x_{max}]\),通常是[0,1]或[-1,1]
\(x^{'}=\frac{x-x_{min}}{x_{max}-x_{min}}\)
2)目的
消除量纲差异:不同特征的单位或量纲可能差异巨大(例如身高以米为单位,体重以千克为单位),归一化可消除这种差异,避免模型被大范围特征主导。
加速模型收敛:对于梯度下降等优化算法,归一化后特征处于相近的尺度,优化路径更平滑,收敛速度更快。
适配特定模型需求:某些模型(如神经网络、K近邻、SVM)对输入数据的范围敏感,归一化能显著提升其性能。
3)适用场景
归一化不改变原始分布形状,但对异常值比较敏感。当数据分布有明显边界(如图像像素值、文本词频),或模型对输入范围敏感时可以优先考虑归一化。
from sklearn.preprocessing import MinMaxScaler

X = [[2, 1], [3, 1], [1, 4], [2, 6]]
# 归一化,区间设置为(-1,1)
X = MinMaxScaler(feature_range=(-1, 1)).fit_transform(X)
print(X)
3.3.2 标准化
1)定义
将数据调整为均值为0、标准差为1的标准分布。
\(x^{'}=\frac{x-\mu}{\sigma}\)
其中\(\mu\)是均值,\(\sigma\)是标准差
2)目的
适应数据分布:将数据转换为均值为0、标准差为1的分布,适合假设数据服从正态分布的模型(如线性回归、逻辑回归)。
稳定模型训练:标准化后的数据对异常值的敏感度较低(相比归一化),鲁棒性更强。
统一特征尺度:与归一化类似,标准化也能消除量纲差异,但更关注数据的统计分布而非固定范围。
3)场景
大多数场景下标准化更通用,尤其是数据分布未知或存在轻微异常值时。
from sklearn.preprocessing import StandardScaler

X = [[2, 1], [3, 1], [1, 4], [2, 6]]
# 标准化
X = StandardScaler().fit_transform(X)
print(X)
3.4 案例1
Heart Disease数据集https://www.kaggle.com/datasets/johnsmith88/heart-disease-dataset
1)特征转换
数据集中包含多种类型的特征:
- 类别型特征(需要特殊处理)
- 胸痛类型:4种分类(名义变量)
- 静息心电图结果:3种分类(名义变量)
- 峰值ST段的斜率:3种分类(有序变量)
- 地中海贫血:4种分类(名义变量)
数值型特征(可直接标准化):年龄、静息血压、胆固醇、最大心率、运动后的ST下降、主血管数量
二元特征(保持原样):性别、空腹血糖、运动性心绞痛
对于类别型特征,直接使用整数编码的类别特征会被算法视为有序数值,导致错误的距离计算(例如:会认为 胸痛类型=1 和 胸痛类型=2 之间的差异比 胸痛类型=1和 胸痛类型=3之间差异更小,而实际上它们都是类别)。使用 独热编码可将类别特征转换为二元向量,消除虚假的顺序关系。
import pandas as pd
from sklearn.model_selection import train_test_split, GridSearchCV
from sklearn.compose import ColumnTransformer
from sklearn.preprocessing import OneHotEncoder, StandardScaler # 独热编码和标准化
from sklearn.neighbors import KNeighborsClassifier
import joblib

# 加载数据集
heart_disease_data = pd.read_csv("../data/heart_disease.csv")

# 处理缺失值
heart_disease_data.dropna(inplace=True)

heart_disease_data.info()


X = heart_disease_data.drop("是否患有心脏病", axis=1)
y = heart_disease_data["是否患有心脏病"]

X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)

print(X_train.shape, X_test.shape, y_train.shape, y_test.shape)

# 特征工程
# 数值型特征
numerical_features = ["年龄", "静息血压", "胆固醇", "最大心率", "运动后的ST下降", "主血管数量"]
# 类别型特征
categorical_features = ["胸痛类型", "静息心电图结果", "峰值ST段的斜率", "地中海贫血"]
# 二元特征
binary_features = ["性别", "空腹血糖", "运动性心绞痛"]

# 创建一个列转换器
columnTransformer = ColumnTransformer(
    transformers=[
        ("num", StandardScaler(), numerical_features),
        ("cat", OneHotEncoder(drop="first"), categorical_features),
        ("bin", "passthrough", binary_features)
    ]
)

# 特征转换
X_train = columnTransformer.fit_transform(X_train)
X_test = columnTransformer.transform(X_test)

# 创建模型
knn = KNeighborsClassifier(n_neighbors=3)
knn.fit(X_train, y_train)

# 模型评估,计算预测准确率
score = knn.score(X_test, y_test)
print(score)

# 保存模型
joblib.dump(value=knn, filename="knn_model")

# 加载模型,对新数据进行预测
knn_loaded = joblib.load("knn_model")
y_pred = knn_loaded.predict(X_test[10:11])
print(f"预测类别:{y_pred}, 真实类别:{y_test[10]}")
3.4 案例2
鸢尾花Iris Dataset数据集是机器学习领域经典数据集,鸢尾花数据集包含了150条鸢尾花信息,每50条取自三个鸢尾花中之一:Versicolour、Setosa和Virginica
# 导入工具包
from sklearn.datasets import load_iris          # 加载鸢尾花测试集的.
import seaborn as sns
import pandas as pd
import matplotlib.pyplot as plt
from sklearn.model_selection import train_test_split    # 分割训练集和测试集的
from sklearn.preprocessing import StandardScaler        # 数据标准化的
from sklearn.neighbors import KNeighborsClassifier      # KNN算法 分类对象
from sklearn.metrics import accuracy_score              # 模型评估的, 计算模型预测的准确率


# 1. 定义函数 dm01_loadiris(), 加载数据集.
def dm01_loadiris():
    # 1. 加载数据集, 查看数据
    iris_data = load_iris()
    print(iris_data)           # 字典形式, 键: 属性名, 值: 数据.
    print(iris_data.keys())

    # 1.1 查看数据集
    print(iris_data.data[:5])
    # 1.2 查看目标值.
    print(iris_data.target)
    # 1.3 查看目标值名字.
    print(iris_data.target_names)
    # 1.4 查看特征名.
    print(iris_data.feature_names)
    # 1.5 查看数据集的描述信息.
    print(iris_data.DESCR)
    # 1.6 查看数据文件路径
    print(iris_data.filename)

# 2. 定义函数 dm02_showiris(), 显示鸢尾花数据.
def dm02_showiris():
    # 1. 加载数据集, 查看数据
    iris_data = load_iris()
    # 2. 数据展示
    # 读取数据, 并设置 特征名为列名.
    iris_df = pd.DataFrame(iris_data.data, columns=iris_data.feature_names)
    # print(iris_df.head(5))
    iris_df['label'] = iris_data.target

    # 可视化, x=花瓣长度, y=花瓣宽度, data=iris的df对象, hue=颜色区分, fit_reg=False 不绘制拟合回归线.
    sns.lmplot(x='petal length (cm)', y='petal width (cm)', data=iris_df, hue='label', fit_reg=False)
    plt.title('iris data')
    plt.show()


# 3. 定义函数 dm03_train_test_split(), 实现: 数据集划分
def dm03_train_test_split():
    # 1. 加载数据集, 查看数据
    iris_data = load_iris()
    # 2. 划分数据集, 即: 特征工程(预处理-标准化)
    x_train, x_test, y_train, y_test = train_test_split(iris_data.data, iris_data.target, test_size=0.2,
                                                        random_state=22)
    print(f'数据总数量: {len(iris_data.data)}')
    print(f'训练集中的x-特征值: {len(x_train)}')
    print(f'训练集中的y-目标值: {len(y_train)}')
    print(f'测试集中的x-特征值: {len(x_test)}')

# 4. 定义函数 dm04_模型训练和预测(), 实现: 模型训练和预测
def dm04_model_train_and_predict():
    # 1. 加载数据集, 查看数据
    iris_data = load_iris()

    # 2. 划分数据集, 即: 数据基本处理
    x_train, x_test, y_train, y_test = train_test_split(iris_data.data, iris_data.target, test_size=0.2, random_state=22)

    # 3. 数据集预处理-数据标准化(即: 标准的正态分布的数据集)
    transfer = StandardScaler()
    # fit_transform(): 适用于首次对数据进行标准化处理的情况,通常用于训练集, 能同时完成 fit() 和 transform()。
    x_train = transfer.fit_transform(x_train)
    # transform(): 适用于对测试集进行标准化处理的情况,通常用于测试集或新的数据. 不需要重新计算统计量。
    x_test = transfer.transform(x_test)

    # 4. 机器学习(模型训练)
    estimator = KNeighborsClassifier(n_neighbors=5)
    estimator.fit(x_train, y_train)

    # 5. 模型评估.
    # 场景1: 对抽取出的测试集做预测.
    # 5.1 模型评估, 对抽取出的测试集做预测.
    y_predict = estimator.predict(x_test)
    print(f'预测结果为: {y_predict}')

    # 场景2: 对新的数据进行预测.
    # 5.2 模型预测, 对测试集进行预测.
    # 5.2.1 定义测试数据集.
    my_data = [[5.1, 3.5, 1.4, 0.2]]
    # 5.2.2 对测试数据进行-数据标准化.
    my_data = transfer.transform(my_data)
    # 5.2.3 模型预测.
    my_predict = estimator.predict(my_data)
    print(f'预测结果为: {my_predict}')

    # 5.2.4 模型预测概率, 返回每个类别的预测概率
    my_predict_proba = estimator.predict_proba(my_data)
    print(f'预测概率为: {my_predict_proba}')

    # 6. 模型预估, 有两种方式, 均可.
    # 6.1 模型预估, 方式1: 直接计算准确率, 100个样本中模型预测正确的个数.
    my_score = estimator.score(x_test, y_test)
    print(my_score)  # 0.9666666666666667

    # 6.2 模型预估, 方式2: 采用预测值和真实值进行对比, 得到准确率.
    print(accuracy_score(y_test, y_predict))


# 在main方法中测试.
if __name__ == '__main__':
    # 1. 调用函数 dm01_loadiris(), 加载数据集.
    # dm01_loadiris()

    # 2. 调用函数 dm02_showiris(), 显示鸢尾花数据.
    # dm02_showiris()

    # 3. 调用函数 dm03_train_test_split(), 查看: 数据集划分
    # dm03_train_test_split()

    # 4. 调用函数 dm04_模型训练和预测(), 实现: 模型训练和预测
    dm04_model_train_and_predict()
3.5 网格搜索
网格搜索(Grid Search)是一种系统化的超参数调优方法,通过遍历预定义的超参数组合,找到使模型性能最优的参数配置。通过自动化调参避免手动试错,提高效率。
网格搜索通常嵌套交叉验证,与交叉验证结合以提高调参的可靠性:
外层循环:遍历参数网格中的每个参数组合。
内层循环:对每个参数组合使用交叉验证评估模型性能。
from sklearn.neighbors import KNeighborsClassifier
from sklearn.model_selection import GridSearchCV

knn = KNeighborsClassifier()
# 网格搜索参数,K值设置为1到10
param_grid = {"n_neighbors": list(range(1, 10))}
# GridSearchCV(estimator=模型, param_grid=网格搜索参数, cv=k折交叉验证)
knn = GridSearchCV(estimator=knn, param_grid=param_grid, cv=10)

# 模型训练
knn.fit(x_train, y_train)
print(pd.DataFrame(knn.cv_results_))  # 所有交叉验证结果
print(knn.best_estimator_)  # 最佳模型
print(knn.best_score_)  # 最佳得分

# 使用最佳模型进行评估
knn = knn.best_estimator_
print(knn.score(x_test, y_test))
4. 过拟合
4.1正则化
在解决回归过拟合中,我们选择正则化。但是对于其他机器学习算法如分类算法来说也会出现这样的问题,除了一些算法本身作用之外(决策树、神经网络),我们更多的也是去自己做特征选择,包括之前说的删除、合并一些特征
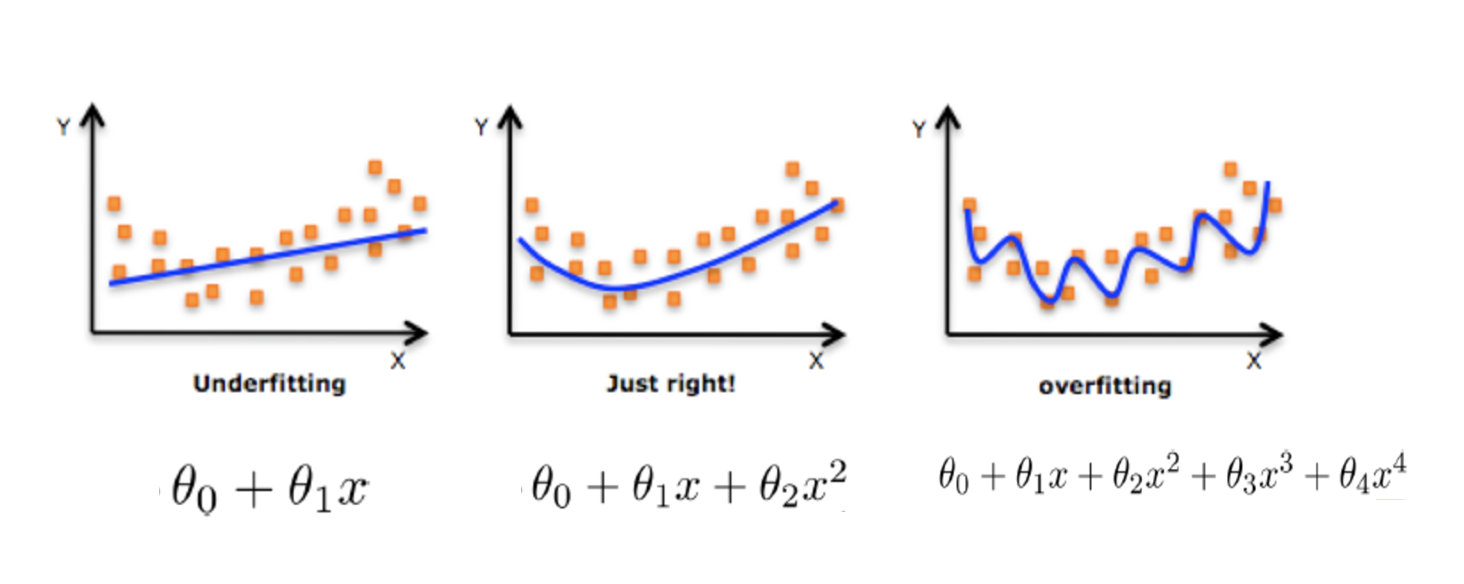
在学习的时候,数据提供的特征有些影响模型复杂度或者这个特征的数据点异常较多,所以算法在学习的时候尽量减少这个特征的影响(甚至删除某个特征的影响),这就是正则化
L1正则化
- 假设𝐿(𝑊)是未加正则项的损失,𝜆是一个超参,控制正则化项的大小。
- 则最终的损失函数:\(𝐿=𝐿(𝑊)+ \lambda*\sum_{i=1}^{n}\lvert w_i\rvert\)
作用:用来进行特征选择,主要原因在于L1正则化会使得较多的参数为0,从而产生稀疏解,可以将0对应的特征遗弃,进而用来选择特征。一定程度上L1正则也可以防止模型过拟合。
# LASSO回归:
from sklearn.linear_model import Lasso
L2正则化
- 假设𝐿(𝑊)是未加正则项的损失,𝜆是一个超参,控制正则化项的大小。
- 则最终的损失函数:\(𝐿=𝐿(𝑊)+ \lambda*\sum_{i=1}^{n}w_{i}^{2}\)
作用:主要用来防止模型过拟合,可以减小特征的权重
优点:越小的参数说明模型越简单,越简单的模型则越不容易产生过拟合现象
# Ridge回归:
from sklearn.linear_model import Ridge
案例
import numpy as np
import matplotlib.pyplot as plt
from sklearn.linear_model import LinearRegression, Lasso, Ridge   # 线性回归模型,Lasso回归,岭回归
from sklearn.preprocessing import PolynomialFeatures    # 构建多项式特征
from sklearn.model_selection import train_test_split
from sklearn.metrics import mean_squared_error


plt.rcParams['font.sans-serif']=['KaiTi']
plt.rcParams['axes.unicode_minus']=False

# 1. 生成数据
X = np.linspace(-3, 3, 300).reshape(-1, 1)
y = np.sin(X) + np.random.uniform(low=-0.5, high=0.5, size=300).reshape(-1, 1)

# 画出散点图(2×3 子图)
fig, ax = plt.subplots(2, 3, figsize=(25, 12))
ax[0,0].scatter(X, y, c='y')
ax[0,1].scatter(X, y, c='y')
ax[0,2].scatter(X, y, c='y')
# plt.show()

# 2. 划分训练集和测试集(验证集)
trainX, testX, trainY, testY = train_test_split(X, y, test_size=0.2, random_state=42)

# 过拟合情况(20次多项式)
poly20 = PolynomialFeatures(degree=20)
x_train = poly20.fit_transform(trainX)
x_test = poly20.fit_transform(testX)
print(x_train.shape)
print(x_test.shape)

# 一、不加正则化项

# 定义模型
model = LinearRegression()

# 4. 训练模型
model.fit(x_train, trainY)

# 5. 预测结果,计算误差
y_pred1 = model.predict(x_test)
test_loss1 = mean_squared_error(testY, y_pred1)

# 画出拟合曲线,并写出训练误差和测试误差
ax[0,0].plot(X, model.predict(poly20.fit_transform(X)), 'r')
ax[0,0].text(-3, 1, f"测试误差:{test_loss1:.4f}")
# 画所有系数的直方图
ax[1,0].bar(np.arange(21), model.coef_.reshape(-1))

# 二、加L1正则化项(Lasso回归)

# 定义模型
lasso = Lasso(alpha=0.01)

# 4. 训练模型
lasso.fit(x_train, trainY)

# 5. 预测结果,计算误差
y_pred2 = lasso.predict(x_test)
test_loss2 = mean_squared_error(testY, y_pred2)

# 画出拟合曲线,并写出训练误差和测试误差
ax[0,1].plot(X, lasso.predict(poly20.fit_transform(X)), 'r')
ax[0,1].text(-3, 1, f"测试误差:{test_loss2:.4f}")
# 画所有系数的直方图
ax[1,1].bar(np.arange(21), lasso.coef_.reshape(-1))

# 三、加L2正则化项(岭回归)

# 定义模型
ridge = Ridge(alpha=1)

# 4. 训练模型
ridge.fit(x_train, trainY)

# 5. 预测结果,计算误差
y_pred3 = ridge.predict(x_test)
test_loss3 = mean_squared_error(testY, y_pred3)

# 画出拟合曲线,并写出训练误差和测试误差
ax[0,2].plot(X, ridge.predict(poly20.fit_transform(X)), 'r')
ax[0,2].text(-3, 1, f"测试误差:{test_loss3:.4f}")
# 画所有系数的直方图
ax[1,2].bar(np.arange(21), ridge.coef_.reshape(-1))

plt.show()
5.分类指标
5.1混淆矩阵
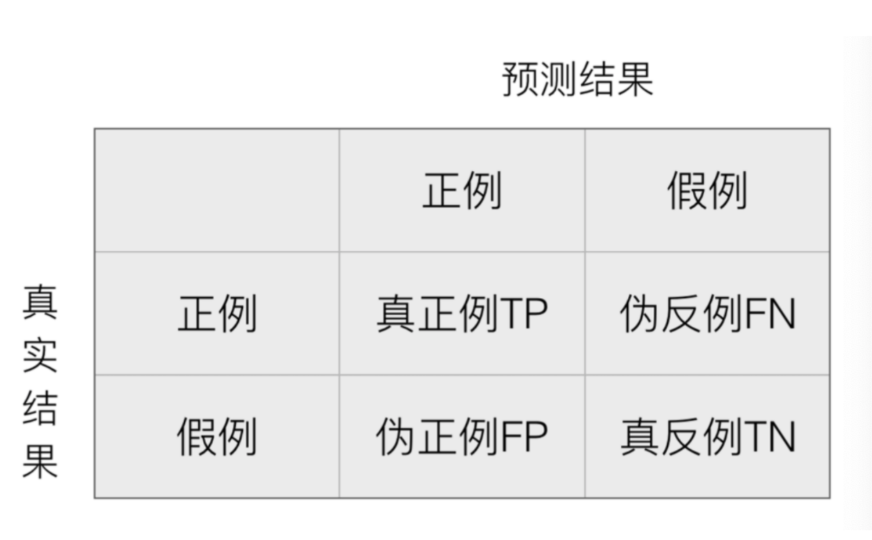
混淆矩阵作用在测试集样本集中:
- 真实值是 正例 的样本中,被分类为 正例 的样本数量有多少(TP,True Positive)
- 真实值是 正例 的样本中,被分类为 假例 的样本数量有多少(FN,False Negative)
- 真实值是 假例 的样本中,被分类为 正例 的样本数量有多少(FP,False Positive)
- 真实值是 假例 的样本中,被分类为 假例 的样本数量有多少(TN,True Negative)
True Positive :表示样本真实的类别 Positive :表示样本被预测为的类别
from sklearn.metrics import confusion_matrix, precision_score, recall_score, f1_score
import pandas as pd


def main():
    # 1. 定义样本集, 6个恶性肿瘤样本, 4个良性肿瘤样本
    y_true = ['恶性', '恶性', '恶性', '恶性', '恶性', '恶性', '良性', '良性', '良性', '良性']

    # 2. 定义标签
    labels = ['恶性', '良性']

    # 3. 模型A => 预测对了 3个恶性, 4个良性.
    y_pred_A = ['恶性', '恶性', '恶性', '良性', '良性', '良性', '良性', '良性', '良性', '良性']
    result = confusion_matrix(y_true, y_pred_A)
    print(pd.DataFrame(result, index=labels, columns=labels))

    # 4. 模型B => 预测对了6个恶性肿瘤样本, 1个良性肿瘤样本.
    y_pred_B = ['恶性', '恶性', '恶性', '恶性', '恶性', '恶性', '恶性', '恶性', '恶性', '良性']
    result = confusion_matrix(y_true, y_pred_B)
    print(pd.DataFrame(result, index=labels, columns=labels))


    # 5. 计算精确率 (precision)
    print(f'模型A精确率: {precision_score(y_true, y_pred_A, pos_label="恶性")}')
    print(f'模型B精确率: {precision_score(y_true, y_pred_B, pos_label="恶性")}')

    # 6. 计算召回率 (recall)
    print(f'模型A召回率: {recall_score(y_true, y_pred_A, pos_label="恶性")}')
    print(f'模型B召回率: {recall_score(y_true, y_pred_B, pos_label="恶性")}')

    # 7. 计算F1值
    print(f'模型A F1值: {f1_score(y_true, y_pred_A, pos_label="恶性")}')
    print(f'模型B F1值: {f1_score(y_true, y_pred_B, pos_label="恶性")}')


if __name__ == '__main__':
    main()
5.2精确率
精确率也叫做查准率,指的是对正例样本的预测准确率
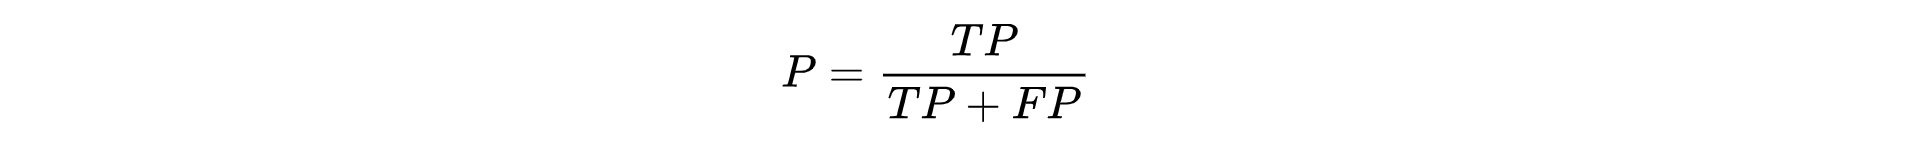
5.3召回率
召回率也叫做查全率,指的是预测为真正例样本占所有真实正例样本的比重。

5.4 F1-score
如果我们对模型的精度、召回率都有要求,希望知道模型在这两个评估方向的综合预测能力如何,则可以使用 F1-score 指标
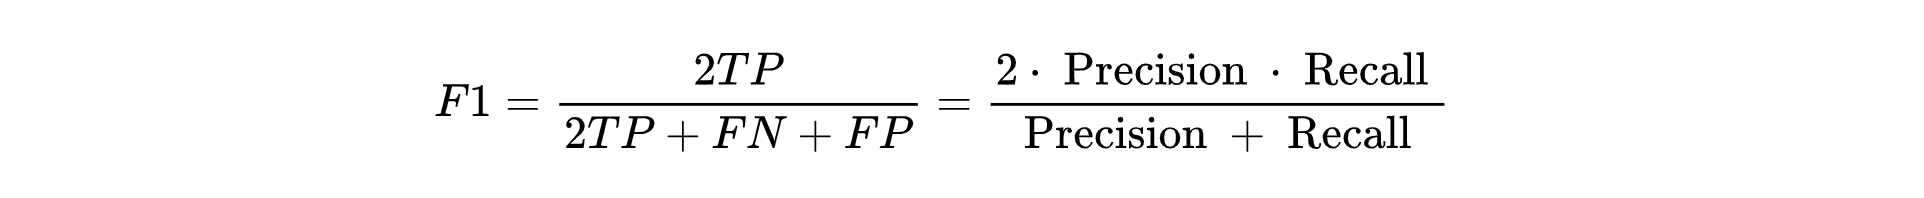
5.5 ROC曲线和AUC指标
ROC曲线的绘制过程: •对于一个给定的二分类模型,首先需要确定一个概率阈值,以用于将模型输出的概率转换为实际的分类结果(正类或负类)。 •通过改变该阈值,可以获得一系列的(FPR, TPR)点。 •将这些点绘制在坐标轴上并连接,便形成了ROC曲线。
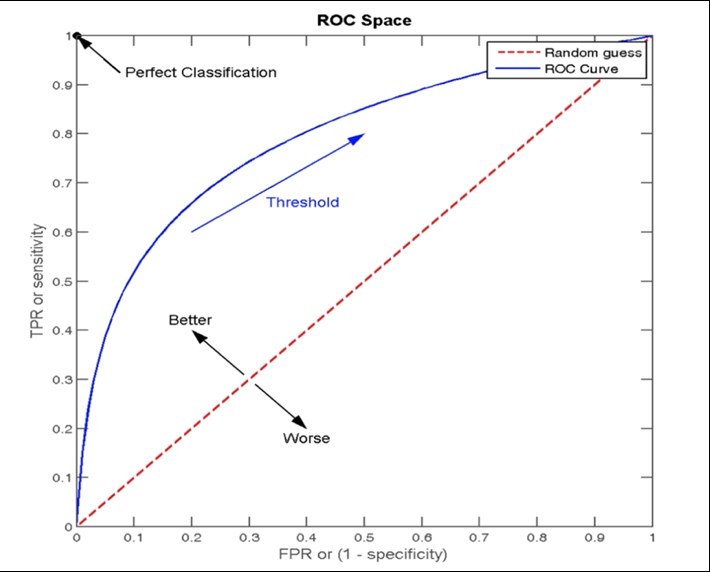
ROC 曲线图像中,4 个特殊点的含义:
- (0, 0) 表示所有的正样本都预测为错误,所有的负样本都预测正确
- (1, 0) 表示所有的正样本都预测错误,所有的负样本都预测错误
- (1, 1) 表示所有的正样本都预测正确,所有的负样本都预测错误
- (0, 1) 表示所有的正样本都预测正确,所有的负样本都预测正确
AUC值:ROC曲线下的面积,用于量化模型好坏或判断模型准确性
对角线(无效曲线):表示随机猜测结果
6. 决策树
决策树是什么?
决策树是一种树形结构,树中每个内部节点表示一个特征上的判断,每个分支代表一个判断结果的输出,每个叶子节点代表一种分类结果
决策树的建立过程:
1.特征选择:选取有较强分类能力的特征。
2.决策树生成:根据选择的特征生成决策树。
3.决策树也易过拟合,采用剪枝的方法缓解过拟合。
ID3决策树
学习目标:
1.理解信息熵的意义
2.理解信息增益的作用
3.知道ID3树的构建流程
信息熵
ID3 树是基于信息增益构建的决策树.
定义
- 熵在信息论中代表随机变量不确定度的度量。
- 熵越大,数据的不确定性度越高
- 熵越小,数据的不确定性越低
公式
\[ \large H = -\sum_{i=1}^{k}p_i\log(p_i) \]
例子1:假如有三个类别,分别占比为:{1/3,1/3,1/3},信息熵计算结果为:
\(H=-\frac{1}{3}\log(\frac{1}{3})-\frac{1}{3}\log(\frac{1}{3})-\frac{1}{3}\log(\frac{1}{3})=1.0986\)
例子2:假如有三个类别,分别占比为:{1/10,2/10,7/10},信息熵计算结果为:
\(H=-\frac{1}{10}\log(\frac{1}{10})-\frac{2}{10}\log(\frac{2}{10})-\frac{7}{10}\log(\frac{7}{10})=0.8018\)
熵越大,表示整个系统不确定性越大,越随机,反之确定性越强。
例子3:假如有三个类别,分别占比为:{1,0,0},信息熵计算结果为:
\(H=-1\log(1)=0\)
信息增益
定义
特征\(A\)对训练数据集D的信息增益\(g(D,A)\),定义为集合\(D\)的熵\(H(D)\)与特征A给定条件下D的熵\(H(D|A)\)之差。即
\[ \large g(D,A)=H(D)-H(D|A) \]
根据信息增益选择特征方法是:对训练数据集D,计算其每个特征的信息增益,并比较它们的大小,并选择信息增益最大的特征进行划分。表示由于特征\(A\)而使得对数据D的分类不确定性减少的程度。
算法:
设训练数据集为D,\(\mid D\mid\)表示其样本个数。设有\(K\)个类\(C_k\),\(k=1,2,\cdots,K\),\(\mid C_k\mid\)为属于类\(C_k\)的样本个数,\(\sum\limits_{k=1}^{K}=\mid{D}\mid\)。设特征A有\(n\)个不同取值\(\{a_1, a_2, \cdots,a_n\}\),根据特征A的取值将D划分为\(n\)个子集\(D_1, D_2, \cdots,D_n\),\(\mid D_i\mid\)为\(D_i\)样本个数,\(\sum\limits_{i=1}^n\mid D_i\mid=\mid D\mid\)。子集中属于类\(C_k\)的样本集合为\(D_{ik}\),即\(D_{ik}=D_i\bigcap C_k\),\(\mid D_{ik}\mid\)为\(D_{ik}\)的样本个数。信息增益算法如下:
输入:训练数据集D和特征A;
输出:特征A对训练数据集D的信息增益\(g(D,A)\)
- 计算数据集D的经验熵\(H(D)\)
\(H(D)=-\sum\limits_{k=1}^{K}\frac{\mid C_k\mid}{\mid D\mid}\log_2\frac{\mid C_k\mid}{\mid D\mid}\)
- 计算特征A对数据集D的经验条件熵\(H(D\mid A)\)
\(H(D\mid A)=\sum\limits_{i=1}^{n}\frac{\mid D_i\mid}{\mid D\mid}H(D_i)=-\sum\limits_{i=1}^{n}\frac{\mid D_i\mid}{\mid D\mid}\sum_\limits{k=1}^{K}\frac{\mid D_{ik}\mid}{\mid D_i\mid}\log_2\frac{\mid D_{ik}\mid}{\mid D_i\mid}\)
- 计算信息增益
\(g(D,A)=H(D)-H(D|A)\)
例子:
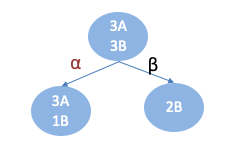
已知6个样本,根据特征a:
| 特征a | 目标值 |
|---|---|
| α | A |
| α | A |
| β | B |
| α | A |
| β | B |
| α | B |
α 部分对应的目标值为: AAAB
β 部分对应的目标值为:BB
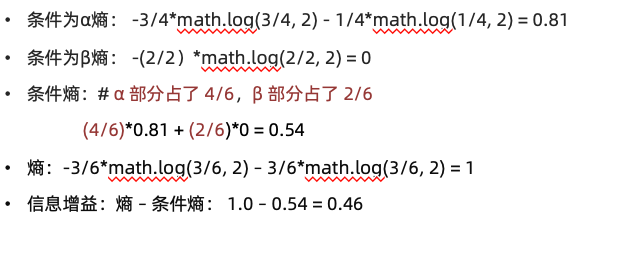
ID3树构建流程
构建流程:
- 计算每个特征的信息增益
- 使用信息增益最大的特征将数据集 S 拆分为子集
- 使用该特征(信息增益最大的特征)作为决策树的一个节点
- 使用剩余特征对子集重复上述(1,2,3)过程
C4.5决策树
信息增益率
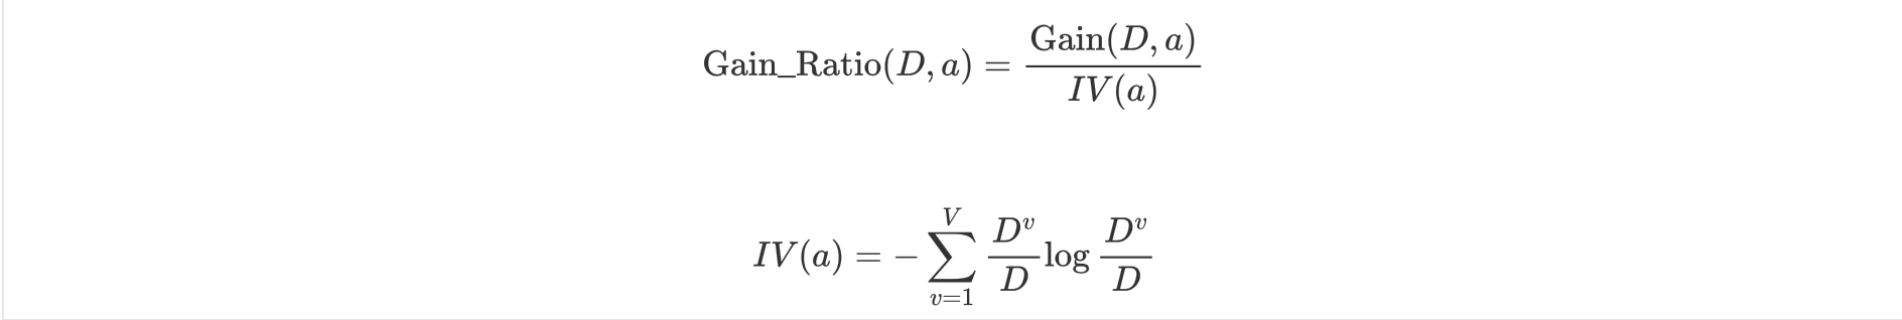
- Gain_Ratio 表示信息增益率
- IV 表示分裂信息、内在信息
- 特征的信息增益 ➗ 内在信息
- 如果某个特征的特征值种类较多,则其内在信息值就越大。即:特征值种类越多,除以的系数就越大。
- 如果某个特征的特征值种类较小,则其内在信息值就越小。即:特征值种类越小,除以的系数就越小。
信息增益比本质: 是在信息增益的基础之上乘上一个惩罚参数。特征个数较多时,惩罚参数较小;特征个数较少时,惩罚参数较大。惩罚参数:数据集D以特征A作为随机变量的熵的倒数。
CART决策树
Cart模型是一种决策树模型,它即可以用于分类,也可以用于回归。
分类和回归树模型采用不同的最优化策略。Cart回归树使用平方误差最小化策略,Cart分类生成树采用的基尼指数最小化策略。
基尼指数计算方法
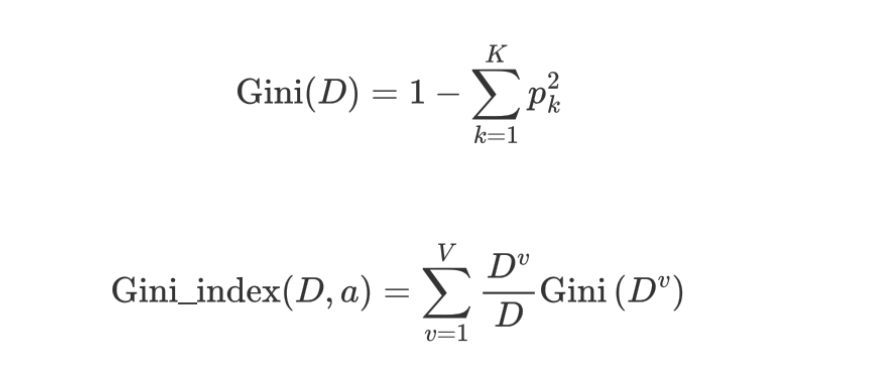
信息增益(ID3)、信息增益率值越大(C4.5),则说明优先选择该特征。
基尼指数值越小(cart),则说明优先选择该特征。
计算举例
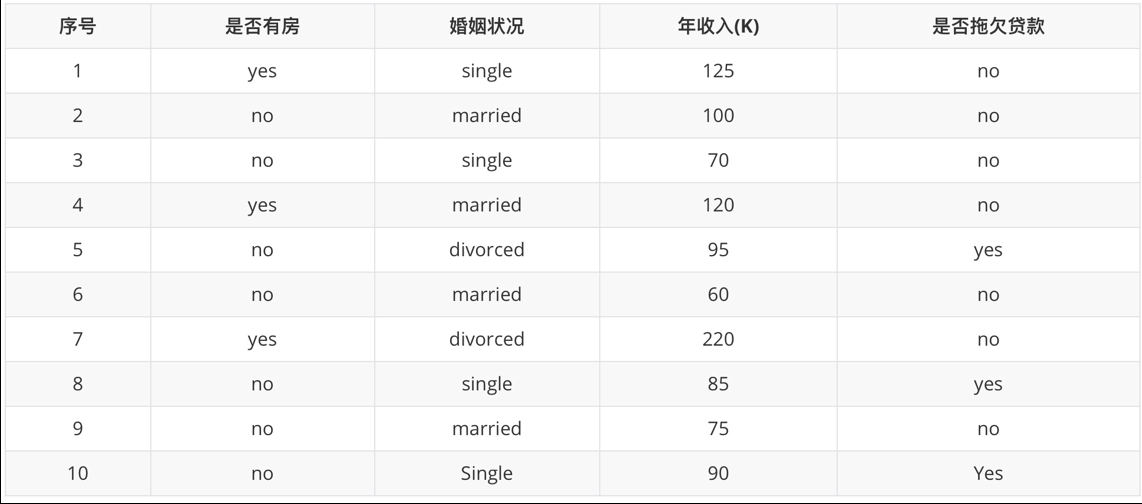
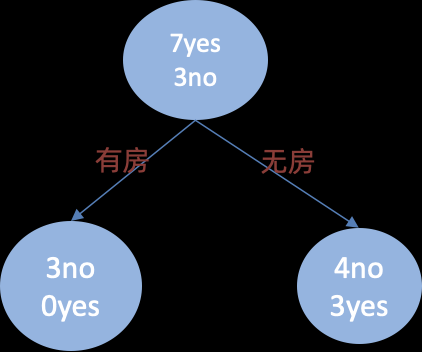
是否有房
计算过程如下:根据是否有房将目标值划分为两部分:
计算有房子的基尼值: 有房子有 1、4、7 共计三个样本,对应:3个no、0个yes
\(G i n i(\text {是否有房,yes })=1-\left(\frac{0}{3}\right)^{2}-\left(\frac{3}{3}\right)^{2}=0\)
计算无房子的基尼值:无房子有 2、3、5、6、8、9、10 共七个样本,对应:4个no、3个yes
\(\operatorname{Gini}(\text {是否有房,no })=1-\left(\frac{3}{7}\right)^{2}-\left(\frac{4}{7}\right)^{2}=0.4898\)
计算基尼指数:第一部分样本数量占了总样本的 3/10、第二部分样本数量占了总样本的 7/10:
\(\operatorname{Gini_{-}} i n \operatorname{dex}(D, \text { 是否有房 })=\frac{7}{10} * 0.4898+\frac{3}{10} * 0=0.343\)
婚姻状况
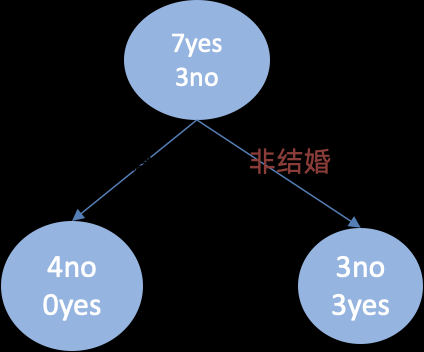
计算 {married} 和 {single,divorced} 情况下的基尼指数:
结婚的基尼值,有 2、4、6、9 共 4 个样本,并且对应目标值全部为 no:
\(\operatorname{Gini\_index}(D,\text{{married}})=0\)
不结婚的基尼值,有 1、3、5、7、8、10 共 6 个样本,并且对应 3 个 no,3 个 yes:
\(\operatorname{Gini\_index}(D, \text { {single,divorced} })=1-\left(\frac{3}{6}\right)^{2}-\left(\frac{3}{6}\right)^{2}=0.5\)
以 married 作为分裂点的基尼指数:
\(\operatorname{Gini\_index}(D, \text { married })=\frac{4}{10} * 0+\frac{6}{10} *\left[1-\left(\frac{3}{6}\right)^{2}-\left(\frac{3}{6}\right)^{2}\right]=0.3\)
计算 {single} | {married,divorced} 情况下的基尼指数
\(\operatorname{Gini\_index}(D,\text{婚姻状况})=\frac{4}{10} * 0.5+\frac{6}{10} *\left[1-\left(\frac{1}{6}\right)^{2}-\left(\frac{5}{6}\right)^{2}\right]=0.367\)
计算 {divorced} | {single,married} 情况下基尼指数
\(\operatorname{Gini\_index}(D, \text { 婚姻状况 })=\frac{2}{10} * 0.5+\frac{8}{10} *\left[1-\left(\frac{2}{8}\right)^{2}-\left(\frac{6}{8}\right)^{2}\right]=0.4\)
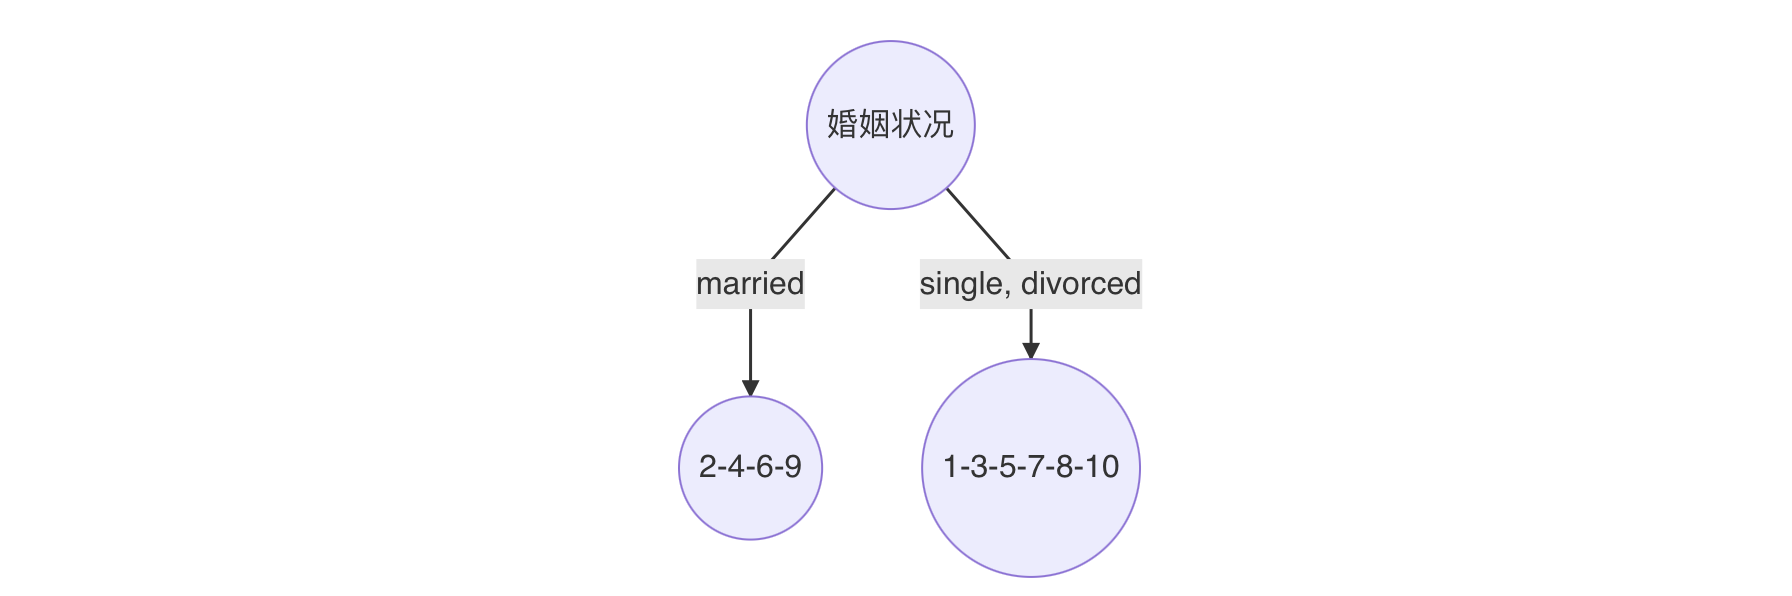
最终:该特征的基尼值为 0.3,并且预选分裂点为:{married} 和 {single,divorced}
年收入
先将数值型属性升序排列,以相邻中间值作为待确定分裂点:
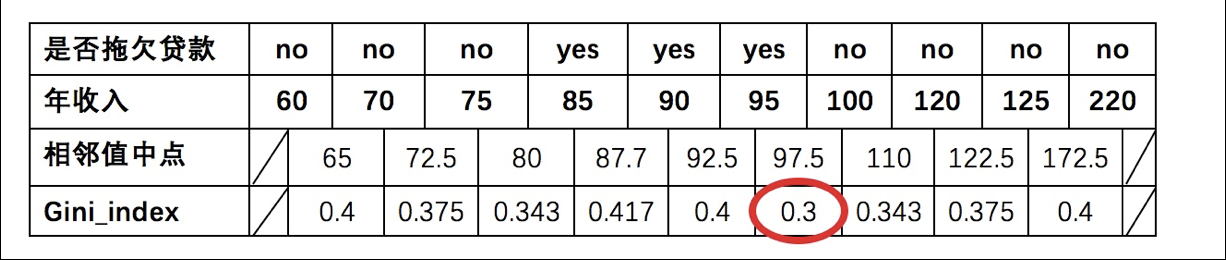
以年收入 65 将样本分为两部分,计算基尼指数:
\(节点为65时:{年收入}=\frac{1}{10} * 0 + \frac{9}{10} *\left[1-\left(\frac{6}{9}\right)^{2}-\left(\frac{3}{9}\right)^{2}\right]=0.4\)
以此类推计算所有分割点的基尼指数,我们发现最小的基尼指数为 0.3。
此时,我们发现:
- 以是否有房作为分裂点的基尼指数为:0.343
- 以婚姻状况为分裂特征、以 married 作为分裂点的基尼指数为:0.3
- 以年收入作为分裂特征、以 97.5 作为分裂点的的基尼指数为:0.3
最小基尼指数有两个分裂点,我们随机选择一个即可,假设婚姻状况,则可确定决策树如下:
重复上面步骤,直到每个叶子结点纯度达到最高.
比较
| 名称 | 提出时间 | 分支方式 | 特点 |
|---|---|---|---|
| ID3 | 1975 | 信息增益 | 1.ID3只能对离散属性的数据集构成决策树 2.倾向于选择取值较多的属性 |
| C4.5 | 1993 | 信息增益率 | 1.缓解了ID3分支过程中总喜欢偏向选择值较多的属性 2.可处理连续数值型属性,也增加了对缺失值的处理方法 3.只适合于能够驻留于内存的数据集,大数据集无能为力 |
| CART | 1984 | 基尼指数 | 1.可以进行分类和回归,可处理离散属性,也可以处理连续属性 2.采用基尼指数,计算量减小 3.一定是二叉树 |
7.回归决策树
CART 回归树和 CART 分类树的不同之处在于:
- CART 分类树预测输出的是一个离散值,CART 回归树预测输出的是一个连续值。
- CART 分类树使用基尼指数作为划分、构建树的依据,CART 回归树使用平方损失。
- 分类树使用叶子节点里出现更多次数的类别作为预测类别,回归树则采用叶子节点里均值作为预测输出
CART 回归树构建:
\[ \operatorname{Loss}(y, f(x))=(f(x)-y)^{2} \]
例子:
假设:数据集只有 1 个特征 x, 目标值值为 y,如下图所示:
| x | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 |
|---|---|---|---|---|---|---|---|---|---|---|
| y | 5.56 | 5.7 | 5.91 | 6.4 | 6.8 | 7.05 | 8.9 | 8.7 | 9 | 9.05 |
由于只有 1 个特征,所以只需要选择该特征的最优划分点,并不需要计算其他特征。
先将特征 x 的值排序,并取相邻元素均值作为待划分点,如下图所示:
s 1.5 2.5 3.5 4.5 5.5 6.5 7.5 8.5 9.5 计算每一个划分点的平方损失,例如:1.5 的平方损失计算过程为:
R1 为 小于 1.5 的样本个数,样本数量为:1,其输出值为:5.56
\(R_1 =5.56\)
R2 为 大于 1.5 的样本个数,样本数量为:9 ,其输出值为:
\(R_2=(5.7+5.91+6.4+6.8+7.05+8.9+8.7+9+9.05) / 9=7.50\)
该划分点的平方损失:
\(L(1.5)=(5.56-5.56)^{2}+\left[(5.7-7.5)^{2}+(5.91-7.5)^{2}+\ldots+(9.05-7.5)^{2}\right]=0+15.72=15.72\)
以此方式计算 2.5、3.5… 等划分点的平方损失,结果如下所示:
s 1.5 2.5 3.5 4.5 5.5 6.5 7.5 8.5 9.5 m(s) 15.72 12.07 8.36 5.78 3.91 1.93 8.01 11.73 15.74 当划分点 s=6.5 时,m(s) 最小。因此,第一个划分变量:特征为 X, 切分点为 6.5,即:j=x, s=6.5
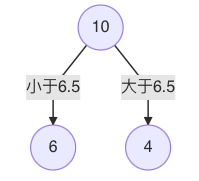
对左子树的 6 个结点计算每个划分点的平方式损失,找出最优划分点:
x 1 2 3 4 5 6 y 5.56 5.7 5.91 6.4 6.8 7.05 s 1.5 2.5 3.5 4.5 5.5 c1 5.56 5.63 5.72 5.89 6.07 c2 6.37 6.54 6.75 6.93 7.05 s 1.5 2.5 3.5 4.5 5.5 m(s) 1.3087 0.754 0.2771 0.4368 1.0644 s=3.5时,m(s) 最小,所以左子树继续以 3.5 进行分裂:
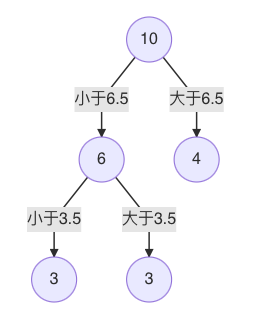
- 假设在生成3个区域 之后停止划分,以上就是回归树。每一个叶子结点的输出为:挂在该结点上的所有样本均值。
| x | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 |
|---|---|---|---|---|---|---|---|---|---|---|
| y | 5.56 | 5.7 | 5.91 | 6.4 | 6.8 | 7.05 | 8.9 | 8.7 | 9 | 9.05 |
1号样本真实值 5.56 预测结果:5.72
2号样本真实值是 5.7 预测结果:5.72
3 号样本真实值是 5.91 预测结果 5.72
CART 回归树构建过程如下:
- 选择第一个特征,将该特征的值进行排序,取相邻点计算均值作为待划分点
- 根据所有划分点,将数据集分成两部分:R1、R2
- R1 和 R2 两部分的平方损失相加作为该切分点平方损失
- 取最小的平方损失的划分点,作为当前特征的划分点
- 以此计算其他特征的最优划分点、以及该划分点对应的损失值
- 在所有的特征的划分点中,选择出最小平方损失的划分点,作为当前树的分裂点
8.集成学习
8.1简介
集成学习是机器学习中的一种思想,它通过多个模型的组合形成一个精度更高的模型,参与组合的模型成为弱学习器(基学习器)。训练时,使用训练集依次训练出这些弱学习器,对未知的样本进行预测时,使用这些弱学习器联合进行预测。
集成学习算法一般分为:bagging和boosting。
Baggging 框架通过有放回的抽样产生不同的训练集,从而训练具有差异性的弱学习器,然后通过平权投票、多数表决的方式决定预测结果。
Boosting 体现了提升思想,每一个训练器重点关注前一个训练器不足的地方进行训练,通过加权投票的方式,得出预测结果。
8.2 随机森林
随机森林是基于 Bagging 思想实现的一种集成学习算法,它采用决策树模型作为每一个基学习器。其构造过程:
- 训练:
- 有放回的产生训练样本
- 随机挑选 n 个特征(n 小于总特征数量)
- 预测:平权投票,多数表决输出预测结果
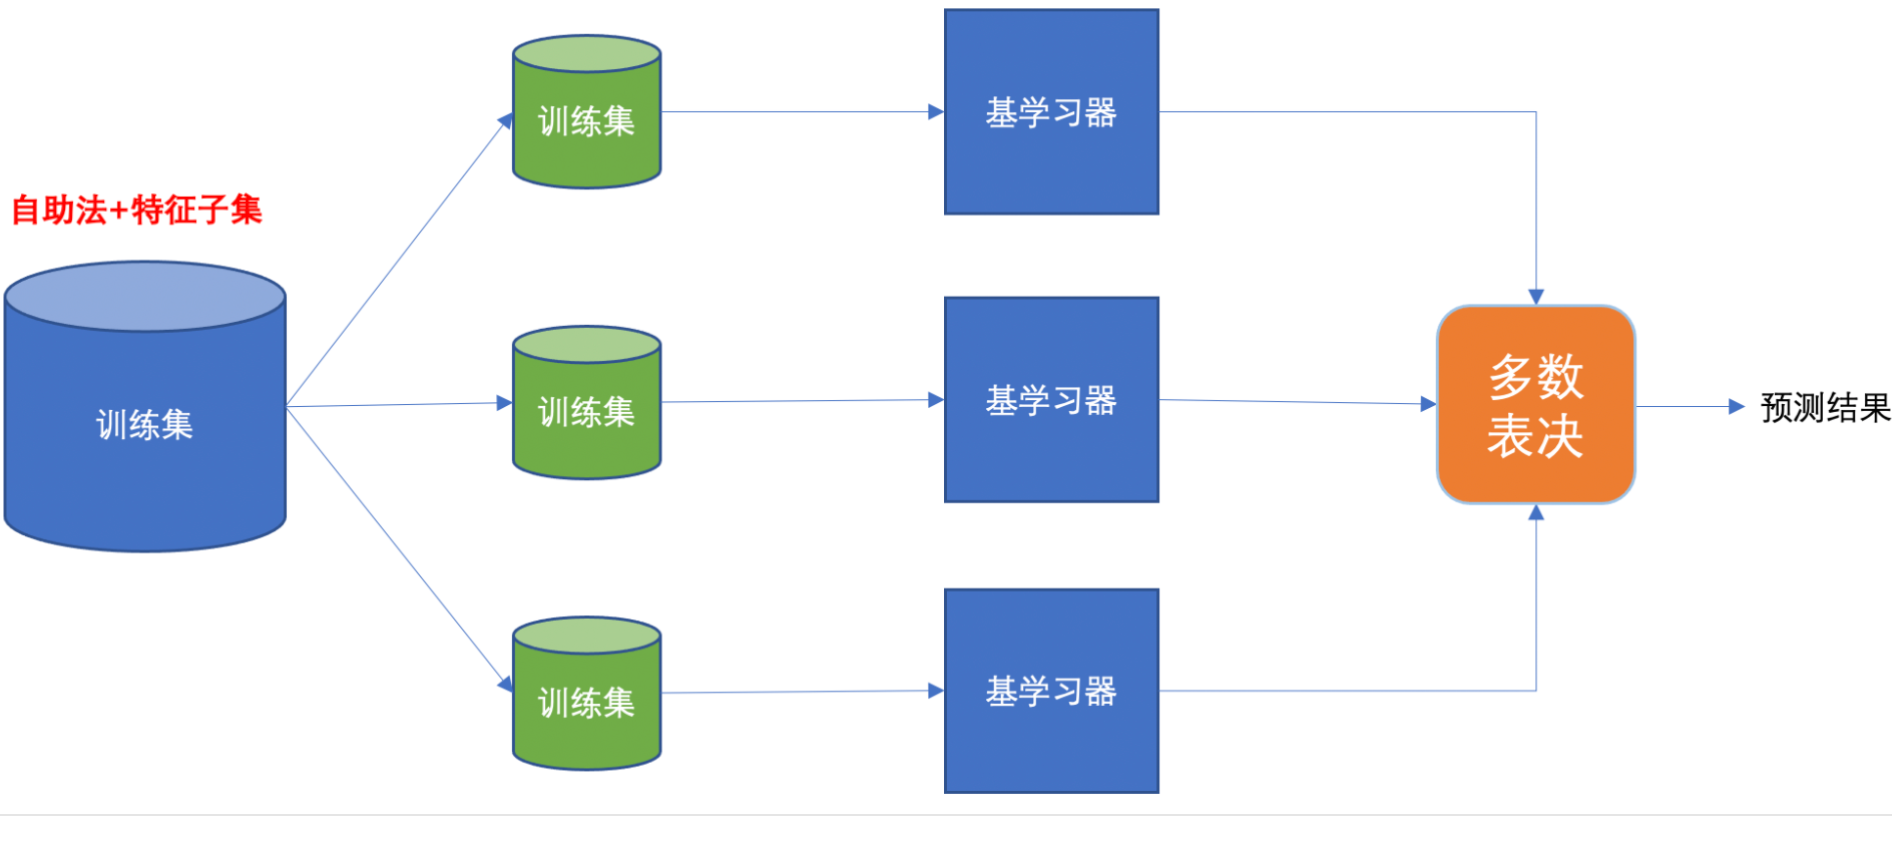
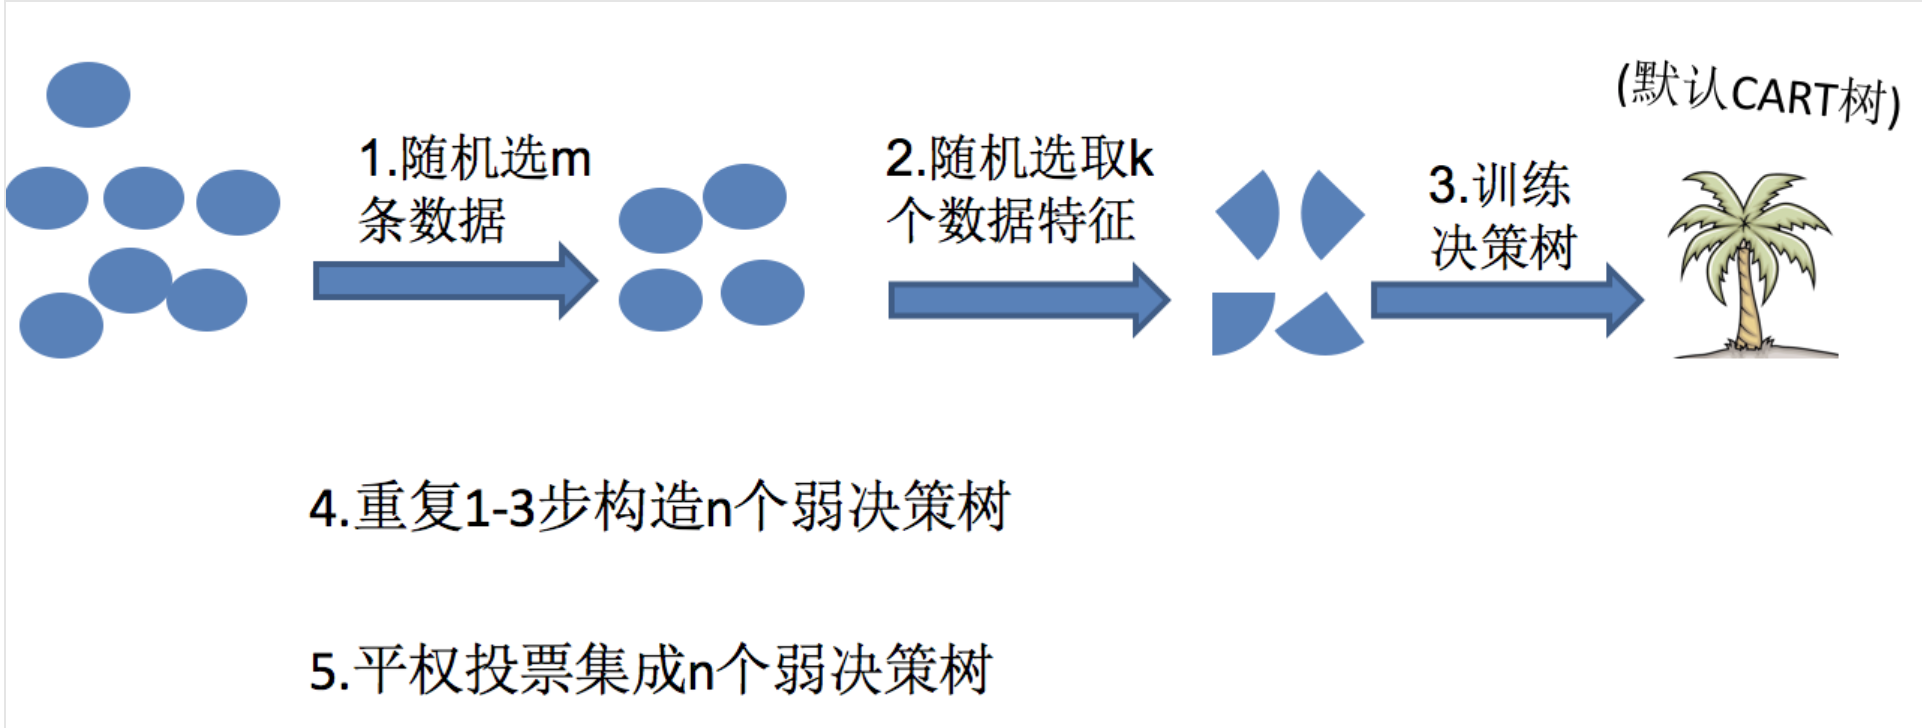
如上图:
首先,对样本数据进行有放回的抽样,得到多个样本集。具体来讲就是每次从原来的N个训练样本中有放回地随机抽取m个样本(包括可能重复样本)。
然后,从候选的特征中随机抽取k个特征,作为当前节点下决策的备选特征,从这些特征中选择最好地划分训练样本的特征。用每个样本集作为训练样本构造决策树。单个决策树在产生样本集和确定特征后,使用CART算法计算,不剪枝。
最后,得到所需数目的决策树后,随机森林方法对这些树的输出进行投票,以得票最多的类作为随机森林的决策。
说明:
(1)随机森林的方法即对训练样本进行了采样,又对特征进行了采样,充分保证了所构建的每个树之间的独立性,使得投票结果更准确。
(2)随机森林的随机性体现在每棵树的训练样本是随机的,树中每个节点的分裂属性也是随机选择的。有了这2个随机因素,即使每棵决策树没有进行剪枝,随机森林也不会产生过拟合的现象。
随机森林中有两个可控制参数:
森林中树的数量(一般选取值较大)
抽取的属性值m的大小。
8.2 Adaboost
Adaptive Boosting(自适应提升)基于 Boosting思想实现的一种集成学习算法核心思想是通过逐步提高那些被前一步分类错误的样本的权重来训练一个强分类器。弱分类器的性能比随机猜测强就行,即可构造出一个非常准确的强分类器。其特点是:训练时,样本具有权重,并且在训练过程中动态调整。被分错的样本的样本会加大权重,算法更加关注难分的样本。
Adaboost自适应在于:
(1)不同的训练集—>调整样本权重
(2)“关注”—>增加错分样本权重
(3)“器重”—>好的分类器权重大
(4) 样本权重间接影响分类器权重
AdaBoost算法的两个核心步骤:
权值调整: AdaBoost算法提高那些被前一轮基分类器错误分类样本的权值,而降低那些被正确分类样本的权值。从而使得那些没有得到正确分类的样本,由于权值的加大而受到后一轮基分类器的更大关注。
基分类器组合: AdaBoost采用加权多数表决的方法。
分类误差率较小的弱分类器的权值大,在表决中起较大作用。
分类误差率较大的弱分类器的权值小,在表决中起较小作用
8.2.1 算法推导
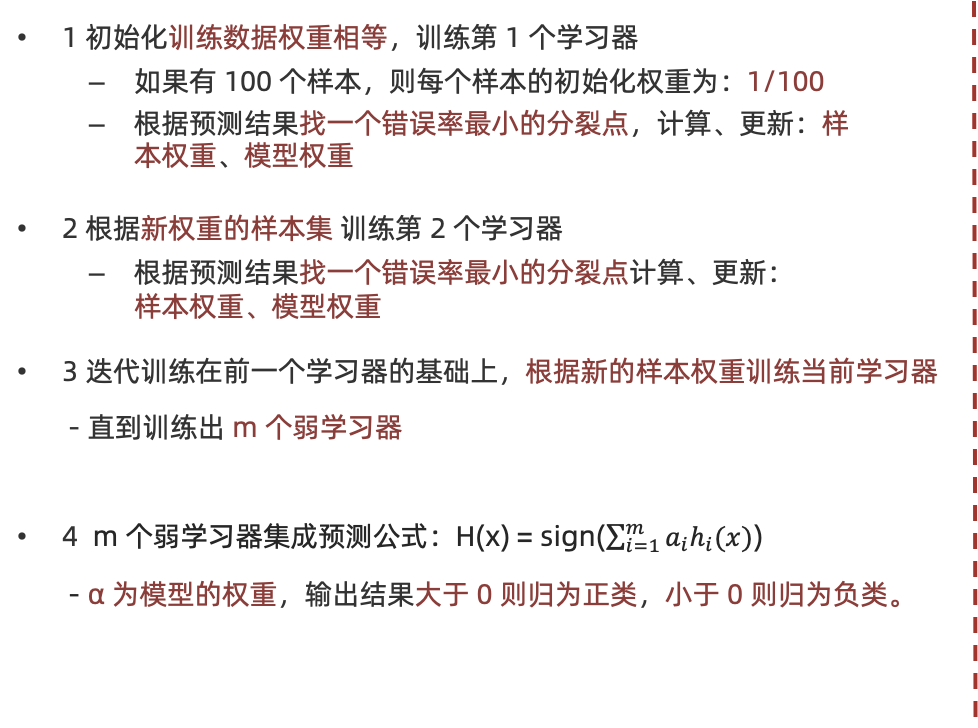
AdaBoost 模型公式中
- α 为模型的权重
- m 为弱学习器数量
- hi(x) 表示弱学习器
- H(x) 输出结果大于 0 则归为正类,小于 0 则归为负类。
AdaBoost 权重更新公式:
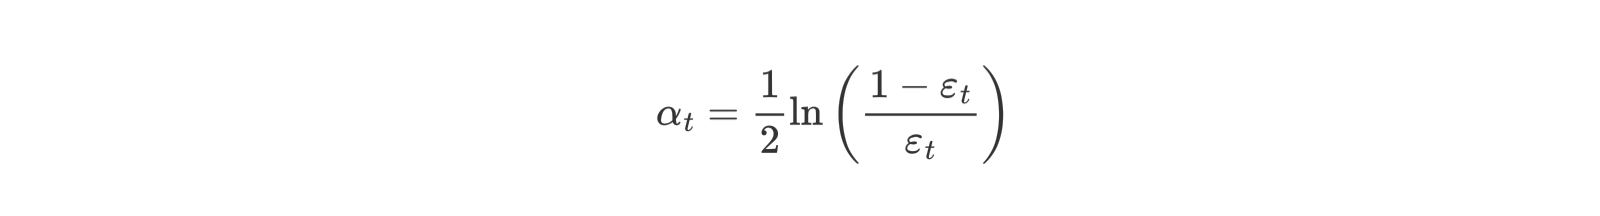
εt 表示第 t 个弱学习器的错误率
AdaBoost 样本权重更新公式:
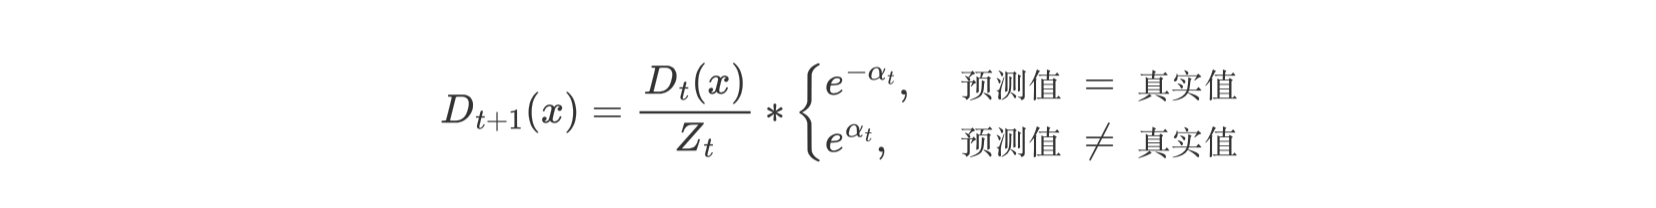
- Zt 为归一化值(所有样本权重的总和)
- Dt(x) 为样本权重
- αt 为模型权重。
8.2.2 构建过程
下面为训练数数据,假设弱分类器由 x 产生,其阈值 v 使该分类器在训练数据集上的分类误差率最低,试用 Adaboost 算法学习一个强分类器。
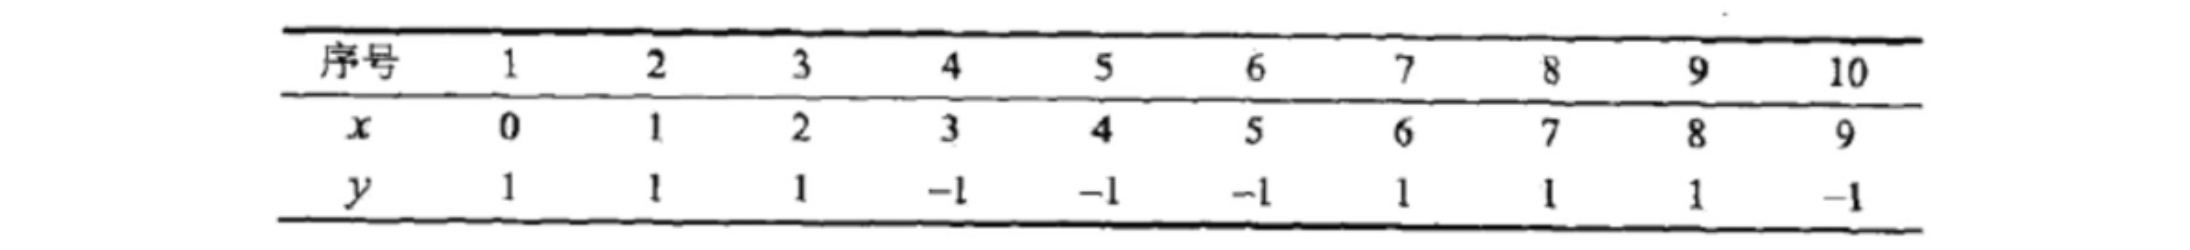
- 构建第一个弱学习器
初始化工作:初始化 10 个样本的权重,每个样本的权重为:0.1
构建第一个基学习器:
寻找最优分裂点
- 对特征值 x 进行排序,确定分裂点为:0.5、1.5、2.5、3.5、4.5、5.5、6.5、7.5、8.5
- 当以 0.5 为分裂点时,有 5 个样本分类错误
- 当以 1.5 为分裂点时,有 4 个样本分类错误
- 当以 2.5 为分裂点时,有 3 个样本分类错误
- 当以 3.5 为分裂点时,有 4 个样本分类错误
- 当以 4.5 为分裂点时,有 5 个样本分类错误
- 当以 5.5 为分裂点时,有 4 个样本分类错误
- 当以 6.5 为分裂点时,有 5 个样本分类错误
- 当以 7.5 为分裂点时,有 4 个样本分类错误
- 当以 8.5 为分裂点时,有 3 个样本分类错误
- 最终,选择以 2.5 作为分裂点,计算得出基学习器错误率为:3/10=0.3
计算模型权重:
1/2 * np.log((1-0.3)/0.3)=0.4236更新样本权重:
- 分类正确样本为:1、2、3、4、5、6、10 共 7 个,其计算公式为:e-αt,则正确样本权重变化系数为:e-0.4236 = 0.6547
- 分类错误样本为:7、8、9 共 3 个,其计算公式为:eαt,则错误样本权重变化系数为:e0.4236 = 1.5275
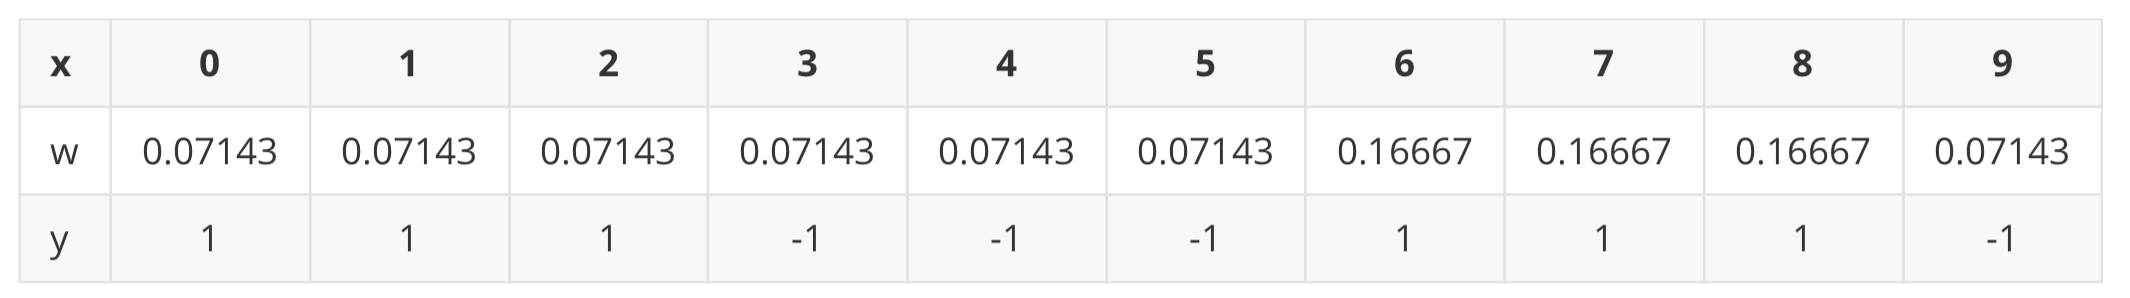
- 样本 1、2、3、4、5、6、10 权重值为:
0.06547 - 样本 7、8、9 的样本权重值为:
0.15275 - 归一化 Zt
值为:
0.06547 * 7 + 0.15275 * 3 = 0.9165 - 样本 1、2、3、4、5、6、10 最终权重值为:
0.07143 - 样本 7、8、9 的样本权重值为:
0.1667
此时得到:
- 构建第二个弱学习器
寻找最优分裂点:
对特征值 x 进行排序,确定分裂点为:0.5、1.5、2.5、3.5、4.5、5.5、6.5、7.5、8.5
当以 0.5 为分裂点时,有 5 个样本分类错误,错误率为:0.07143 * 5 = 0.35715
当以 1.5 为分裂点时,有 4 个样本分类错误,错误率为:0.07143 * 1 + 0.16667 * 3 = 0.57144
当以 2.5 为分裂点时,有 3 个样本分类错误,错误率为:0.16667 * 3 = 0.57144
。。。 。。。
当以 8.5 为分裂点时,有 3 个样本分类错误,错误率为:0.07143 * 3 = 0.21429
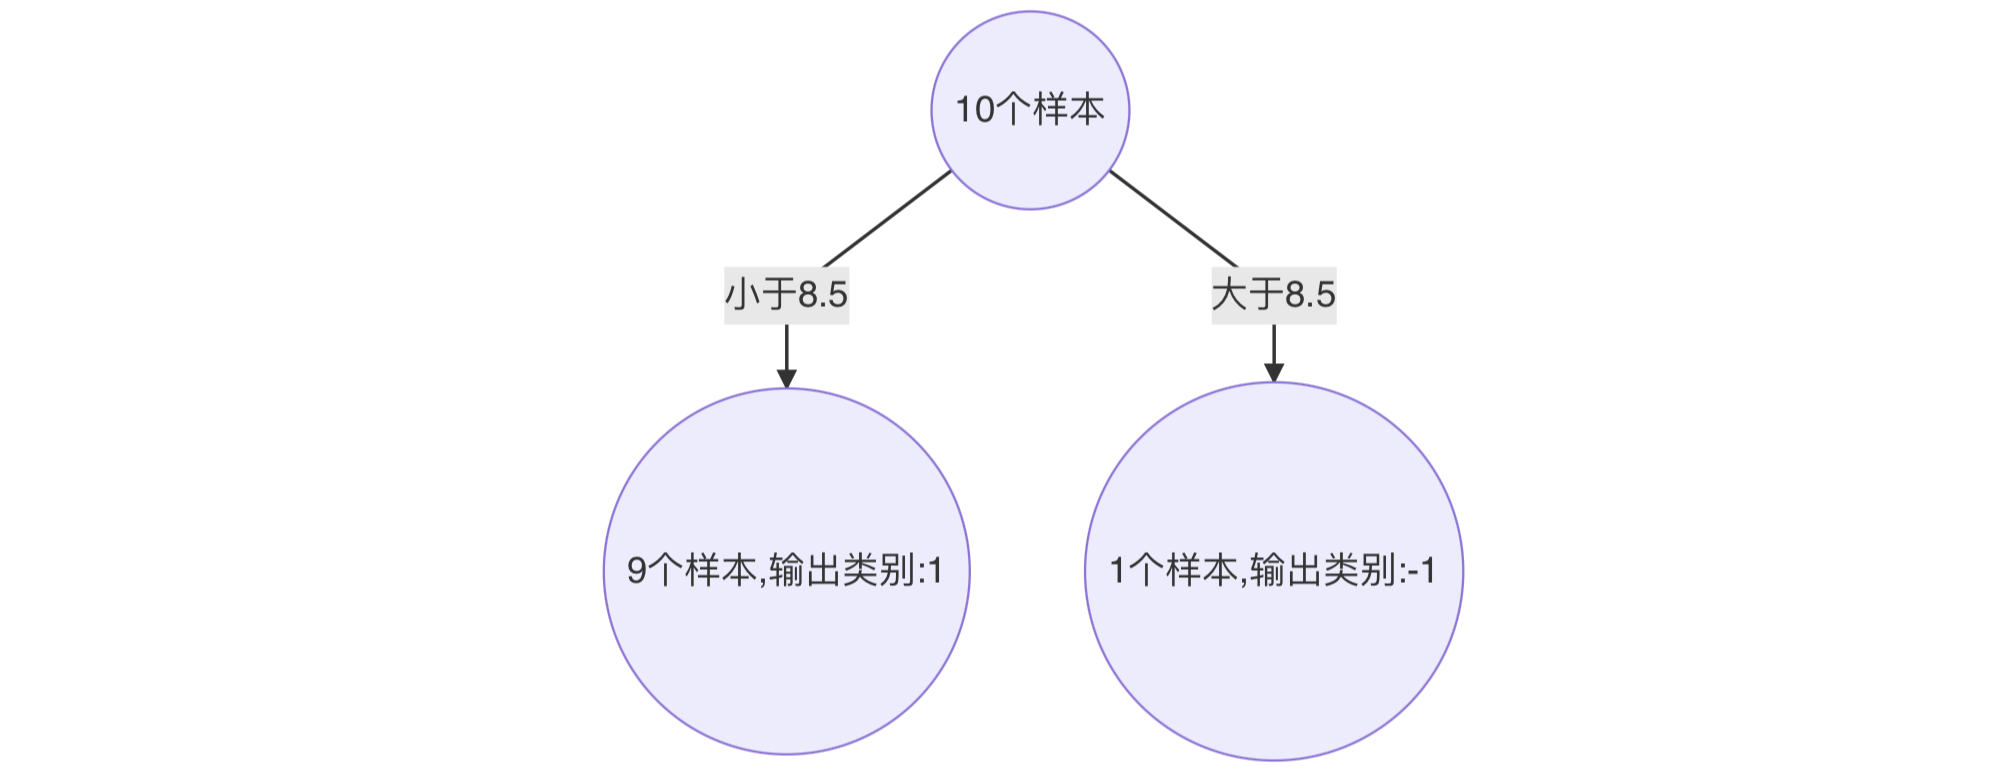
最终,选择以 8.5 作为分裂点,计算得出基学习器错误率为:0.21429
计算模型权重:
1/2 * np.log((1-0.21429)/0.21429)=0.64963分类正确的样本:1、2、3、7、8、9、10,其权重调整系数为:0.5222
分类错误的样本:4、5、6,其权重调整系数为:1.9148
分类正确样本权重值:
- 样本 0、1、2、、9 为:0.0373
- 样本 6、7、8 为:0.087
分类错误样本权重值:0.1368
归一化 Zt 值为:
0.0373 * 4 + 0.087 * 3 + 0.1368 * 3 = 0.8206最终权重:
- 样本 0、1、2、9 为 :0.0455
- 样本 6、7、8 为:0.1060
- 样本 3、4、5 为:0.1667
此时得到:
以此类推
8.3 GBDT
8.3.1 提升树(Boosting Tree)
梯度提升树(Gradient Boosting Decision Tre)是提升树(Boosting Decision Tree)的一种改进算法,所以在讲梯度提升树之前先来介绍一下提升树。
假如有个人30岁,我们首先用20岁去拟合,发现损失有10岁,这时我们用6岁去拟合剩下的损失,发现差距还有4岁,第三轮我们用3岁拟合剩下的差距,差距就只有一岁了。如果我们的迭代轮数还没有完,可以继续迭代下面,每一轮迭代,拟合的岁数误差都会减小。最后将每次拟合的岁数加起来便是模型输出的结果。
8.3.2梯度提升树
梯度提升树不再使用拟合残差,而是利用最速下降的近似方法,利用损失函数的负梯度作为提升树算法中的残差近似值。
假设:
- 我们前一轮迭代得到的强学习器是:fi-1(x)
- 损失函数是:L(y,fi−1(x))
- 本轮迭代的目标是找到一个弱学习器:hi(x)
- 让本轮的损失最小化: L(y, fi(x))=L(y, fi−1(x)) + hi(x))
当采用平方损失函数时:
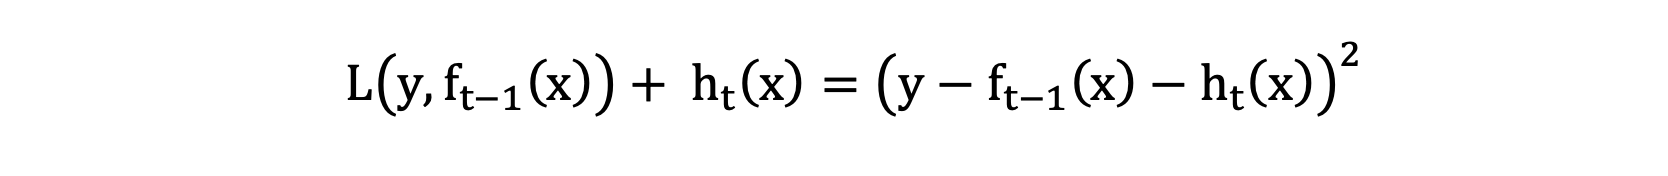
则:
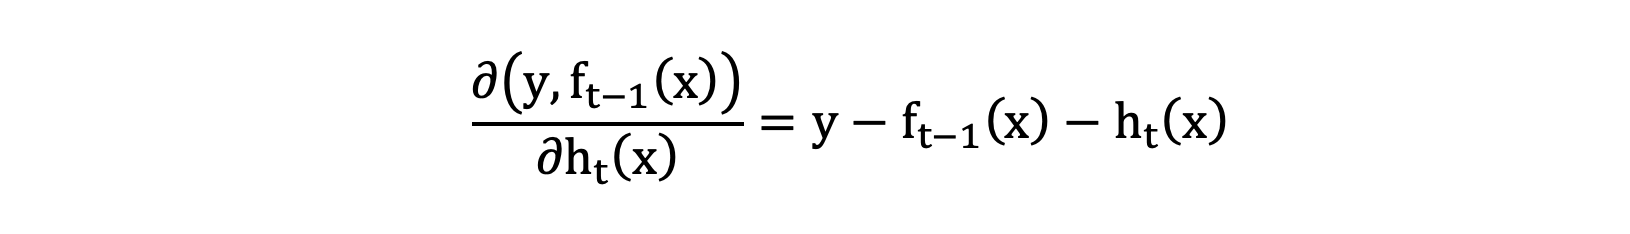
损失函数为平方损失, 则每个样本要拟合的负梯度为:
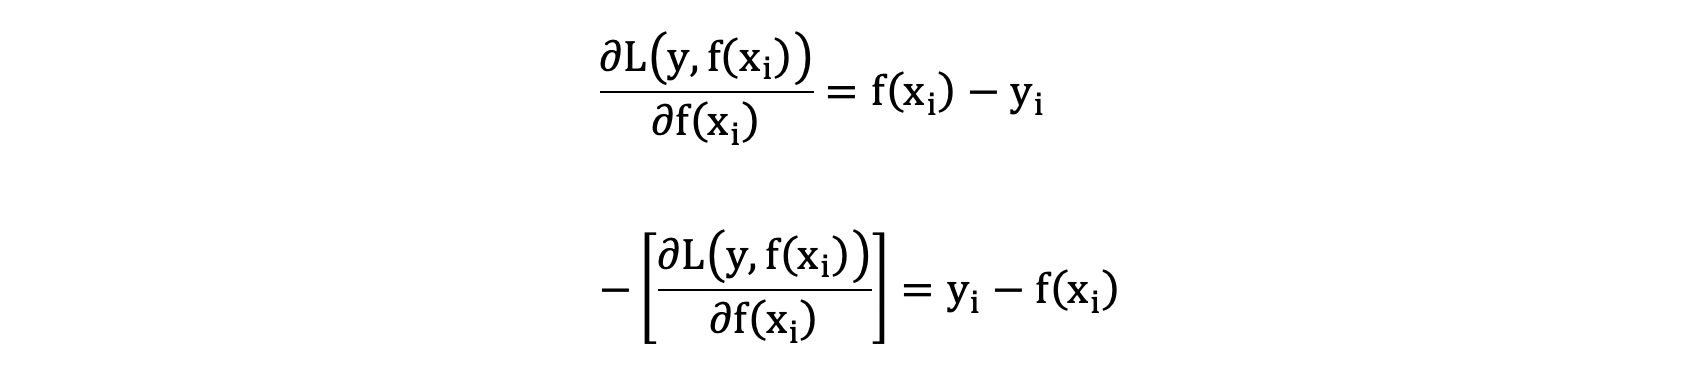
此时, 我们发现 GBDT 拟合的负梯度就是残差,或者说对于回归问题,拟合的目标值就是残差。
如果我们的 GBDT 进行的是分类问题,则损失函数变为 logloss,此时拟合的目标值就是该损失函数的负梯度值。
8.3.3 案例

- 初始化弱学习器(CART树)
我们通过计算当模型预测值为何值时,会使得第一个基学习器的平方误差最小,即:求损失函数对 f(xi) 的导数,并令导数为0.
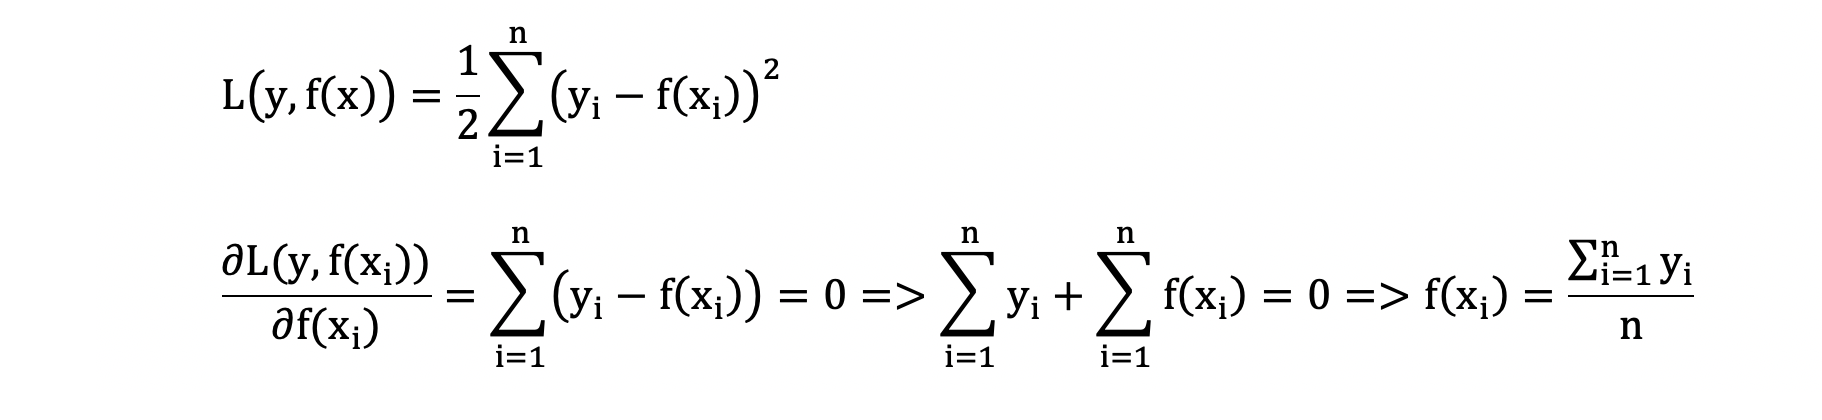
- 构建第一个弱学习器(CART树)
由于我们拟合的是样本的负梯度,即:
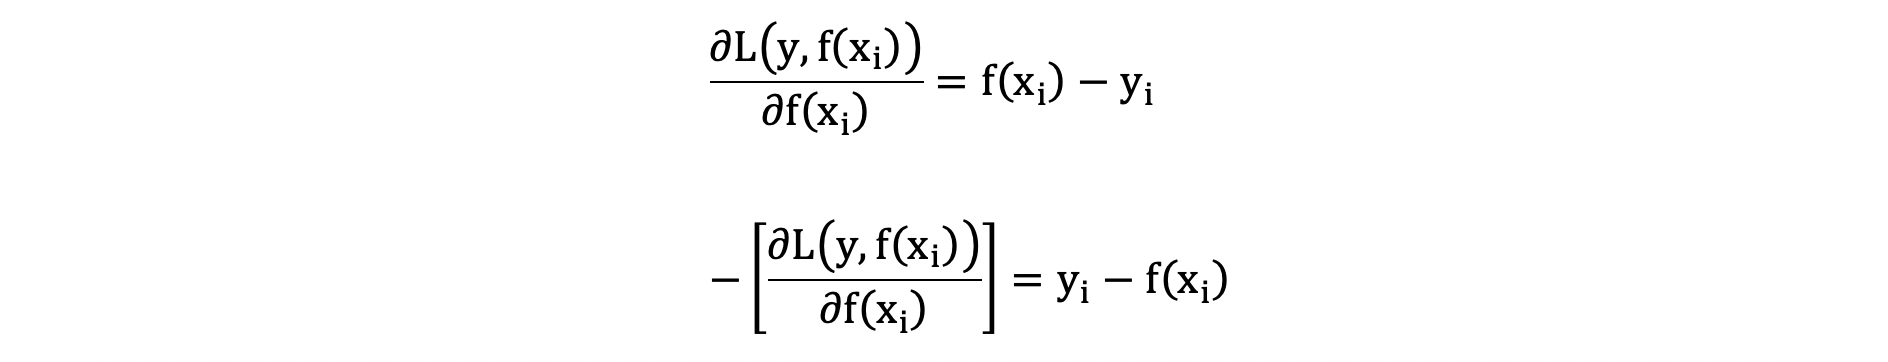
由此得到数据表如下:
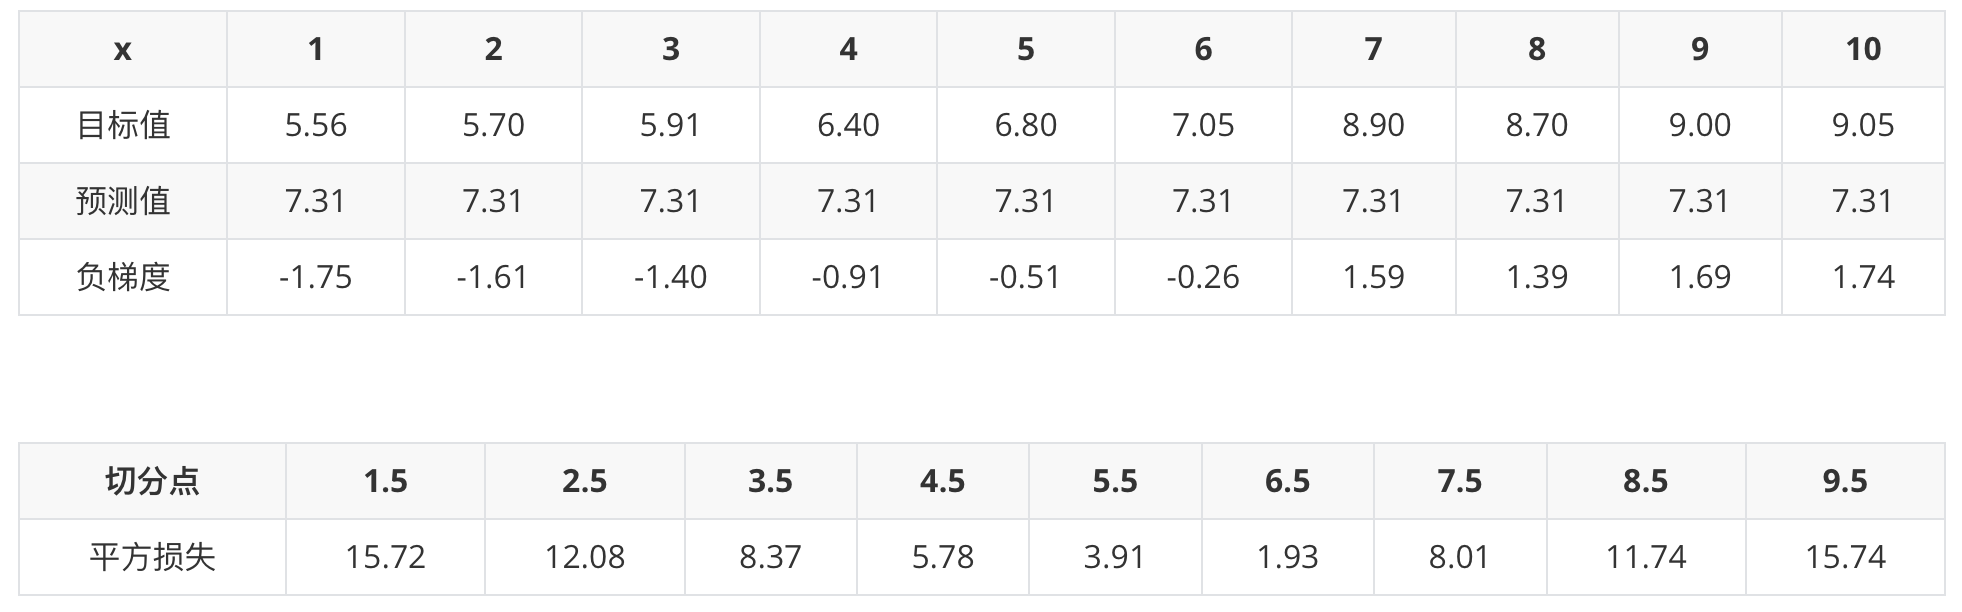
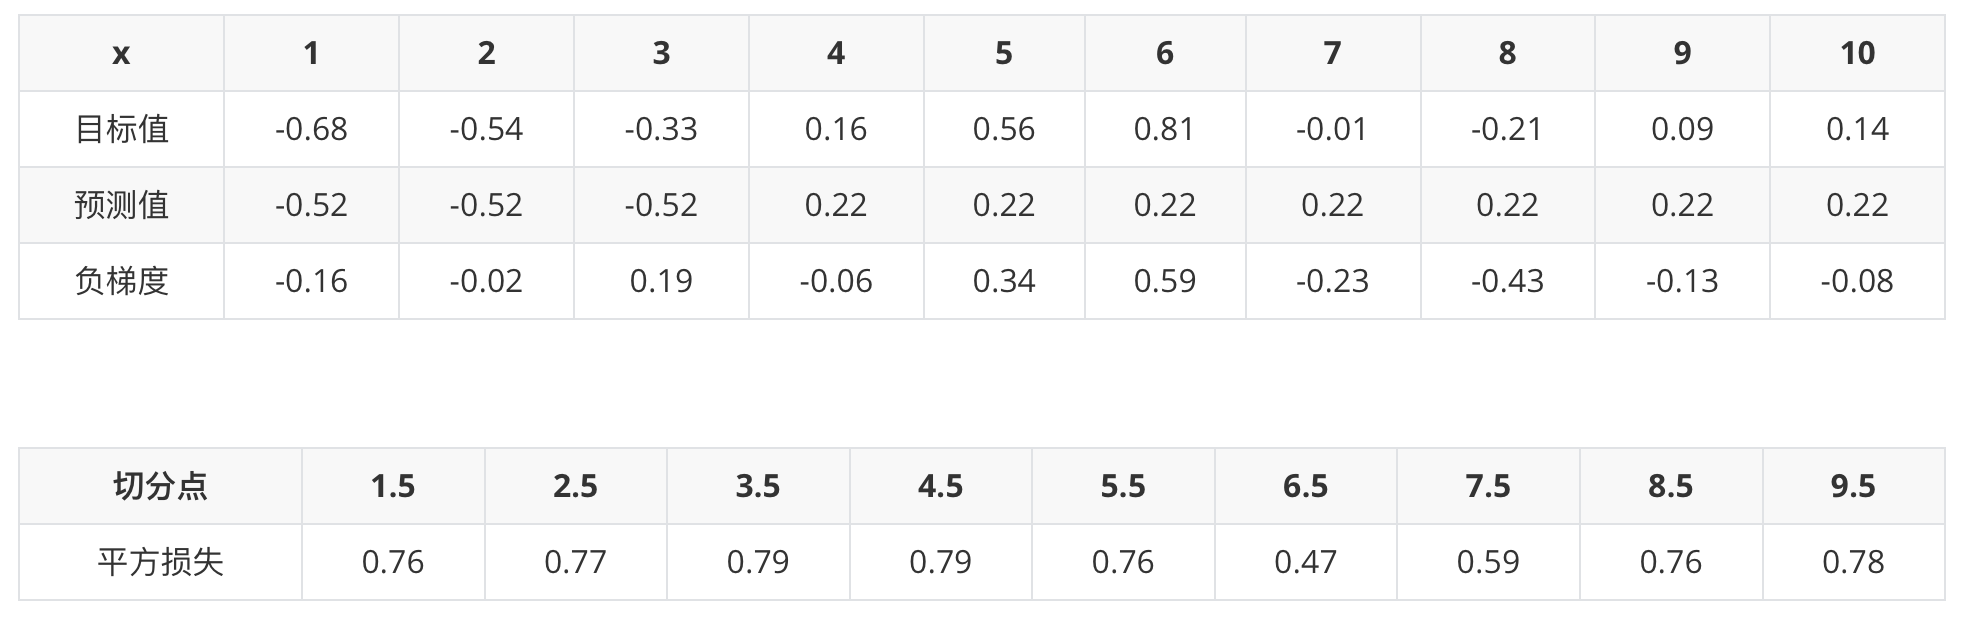
上表中平方损失计算过程说明(以切分点1.5为例):
切分点1.5 将数据集分成两份 [5.56],[5.56 5.7 5.91 6.4 6.8 7.05 8.9 8.7 9. 9.05]
第一份的平均值为5.56 第二份数据的平均值为(5.7+5.91+6.4+6.8+7.05+8.9+8.7+9+9.05)/9 = 7.5011
由于是回归树,每份数据的平均值即为预测值,则可以计算误差,第一份数据的误差为0,第二份数据的平方误差为 :
\((5.70-7.5011)^2+(5.91-7.5011)^2+...+(9.05-7.5011)^2 = 15.72308\)
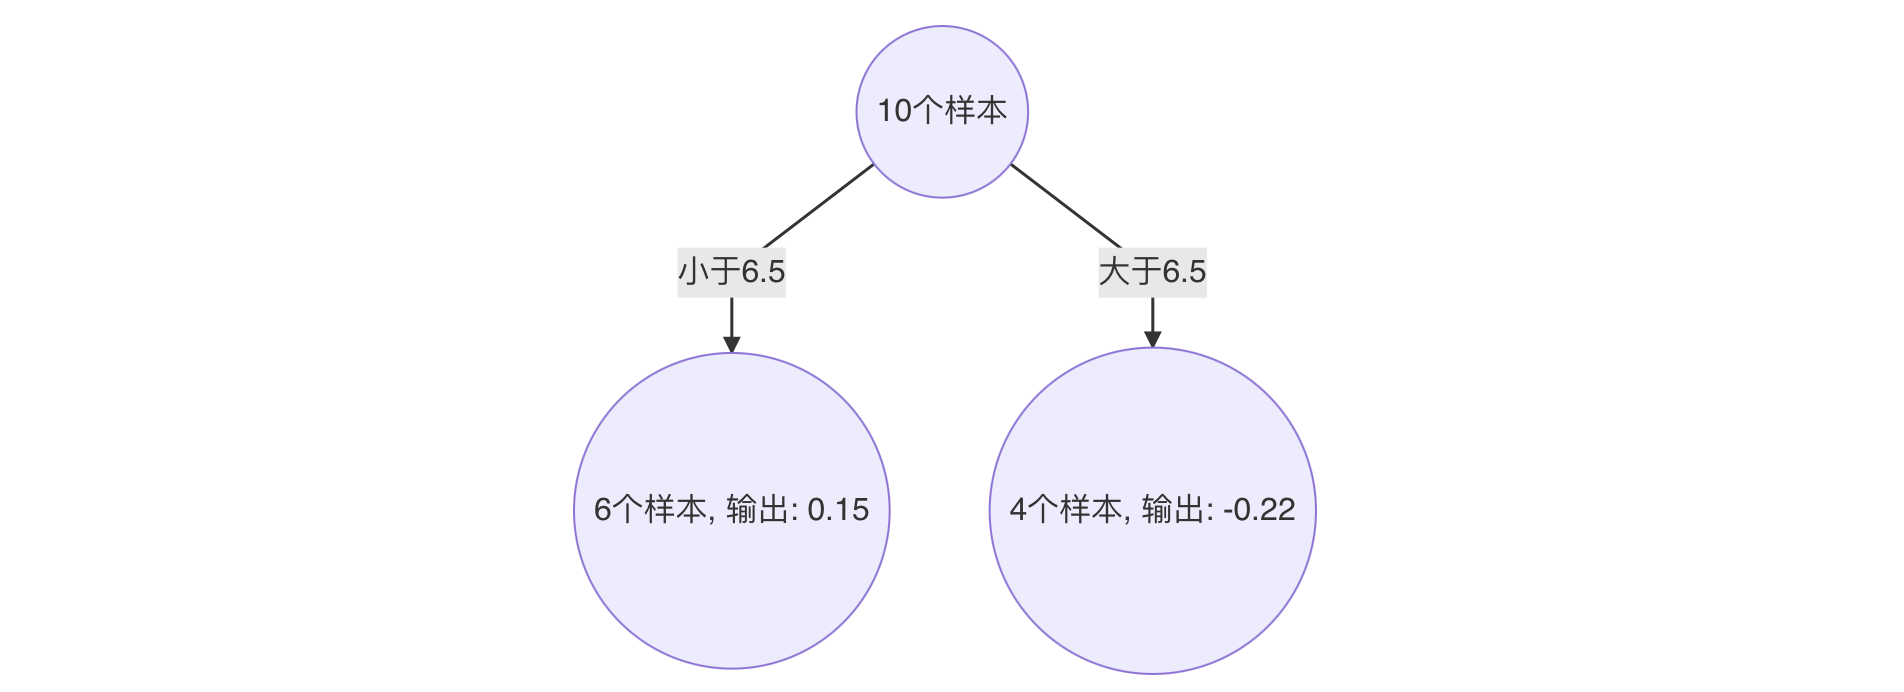
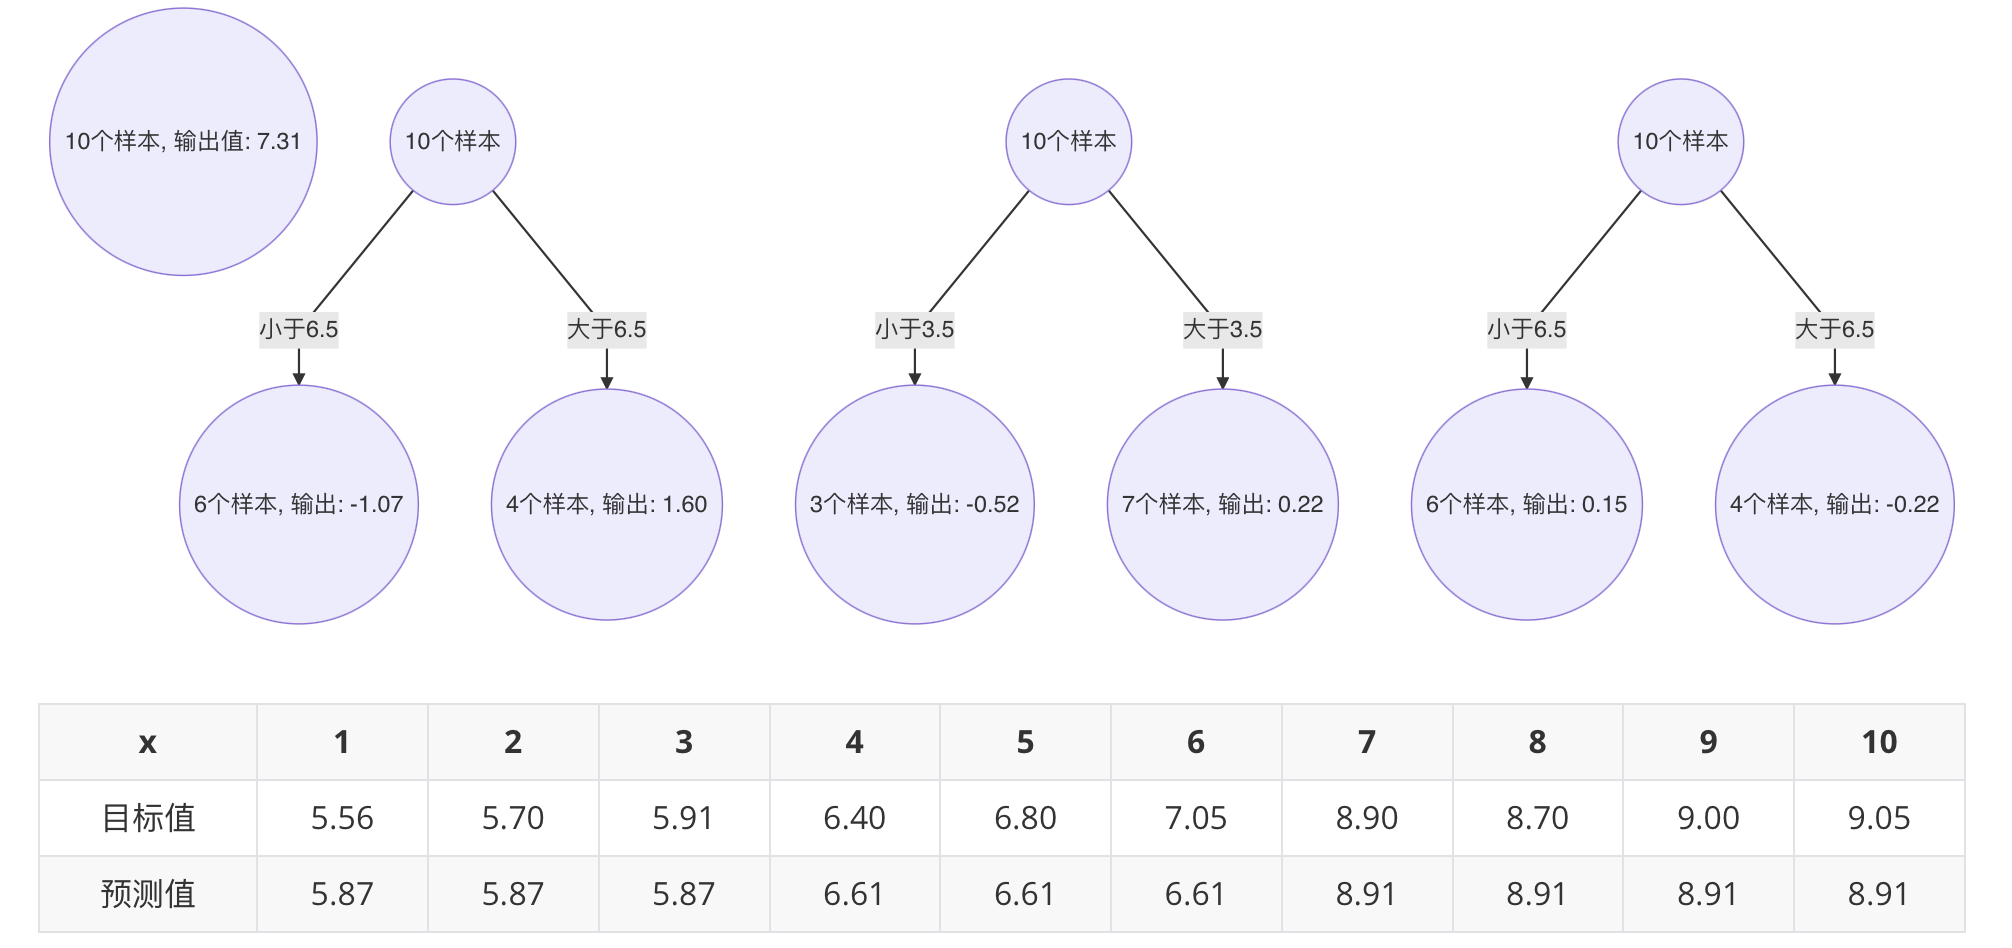
以 6.5 作为切分点损失最小,构建决策树如下:
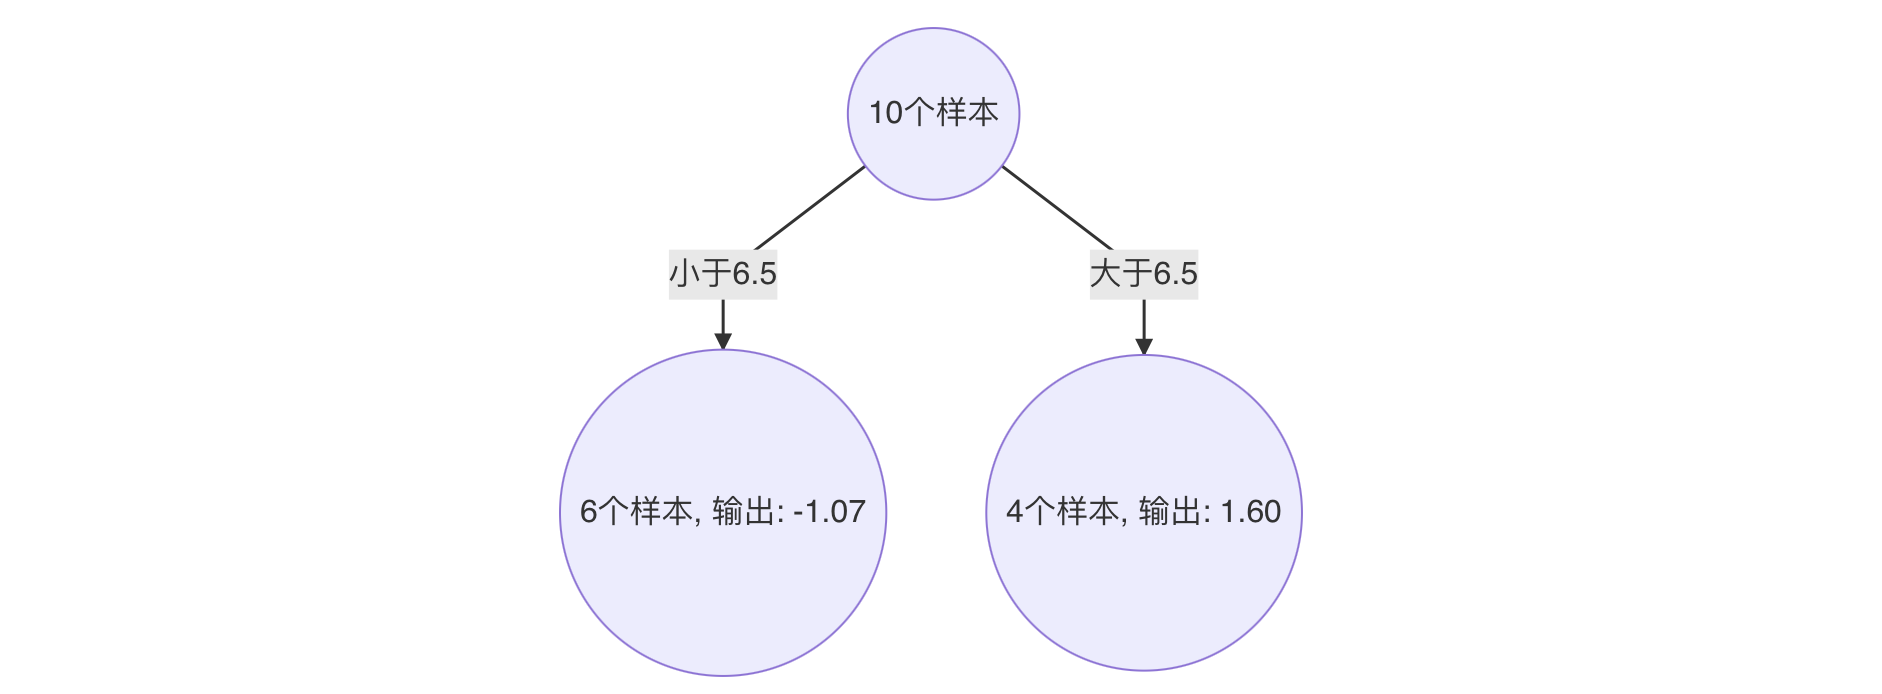
构建第二个弱学习器(CART树)
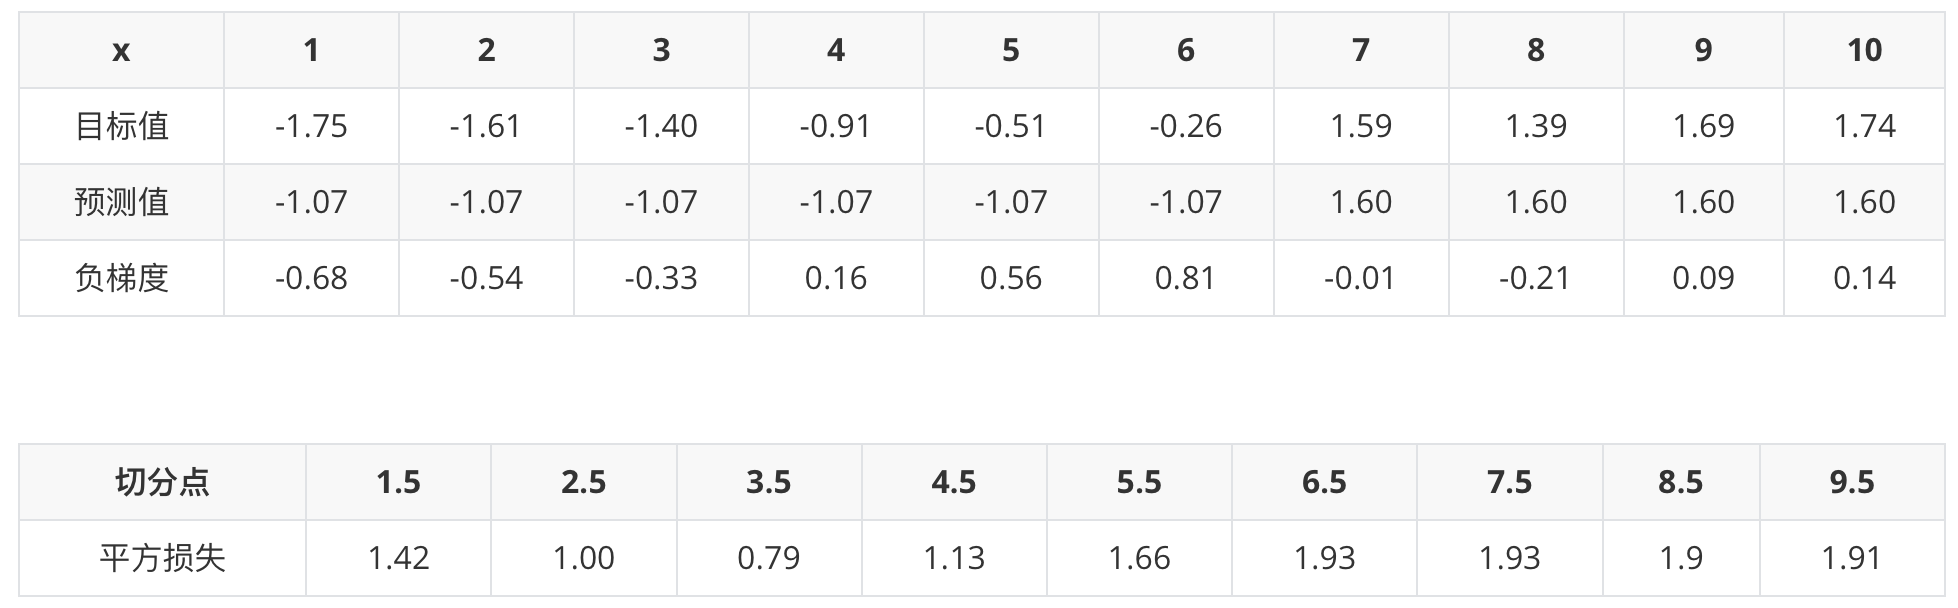
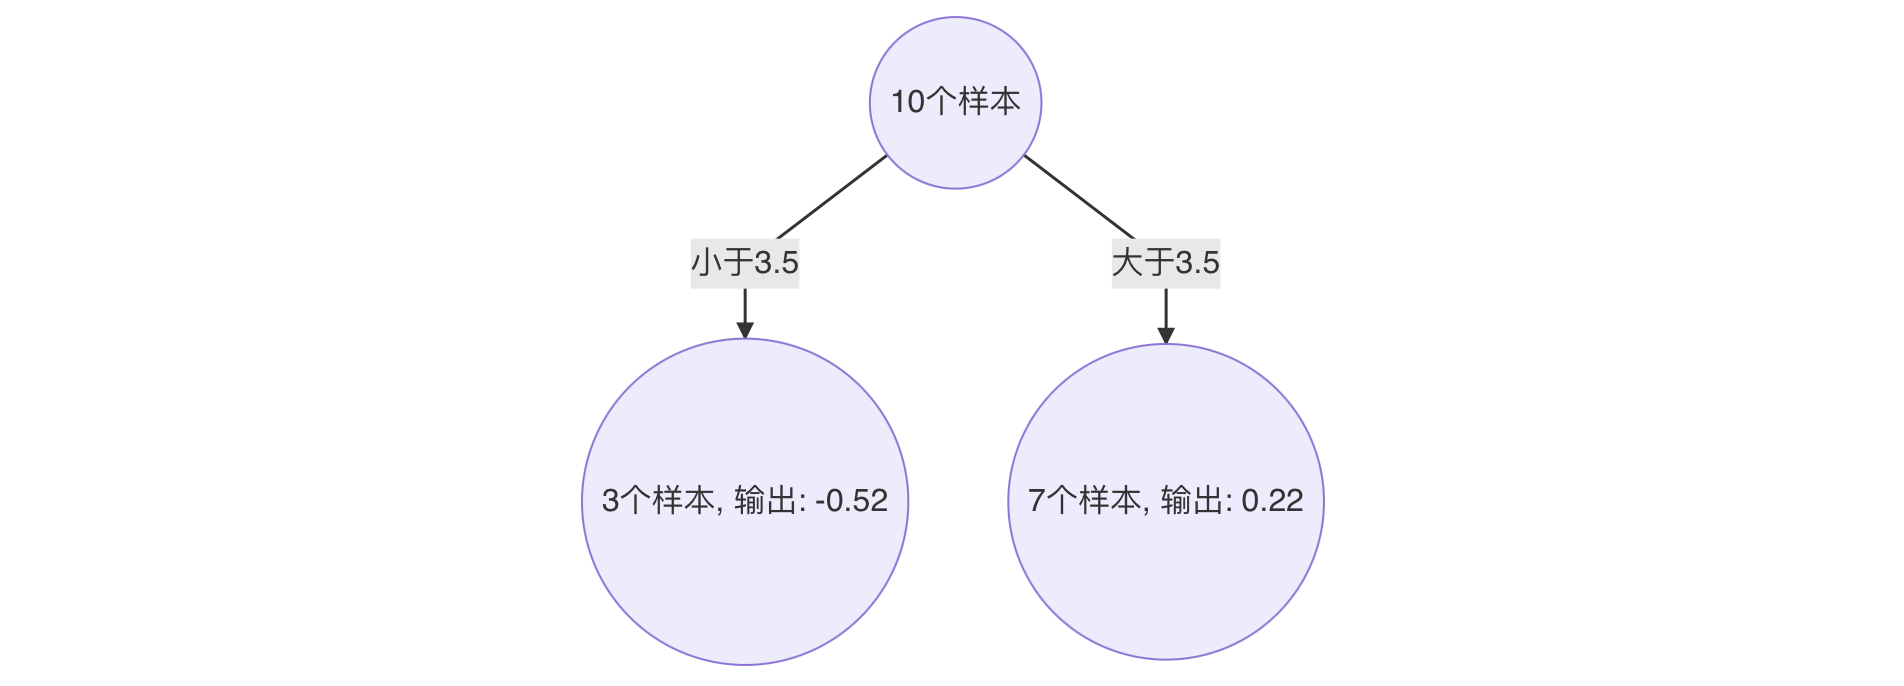
以 3.5 作为切分点损失最小,构建决策树如下:
构建第三个弱学习器(CART树)
以 6.5 作为切分点损失最小,构建决策树如下:
- 最终强学习器
- GBDT算法流程
1 初始化弱学习器(目标值的均值作为预测值)
2 迭代构建学习器,每一个学习器拟合上一个学习器的负梯度
3 直到达到指定的学习器个数
4 当输入未知样本时,将所有弱学习器的输出结果组合起来作为强学习器的输出
8.4 XGBoost
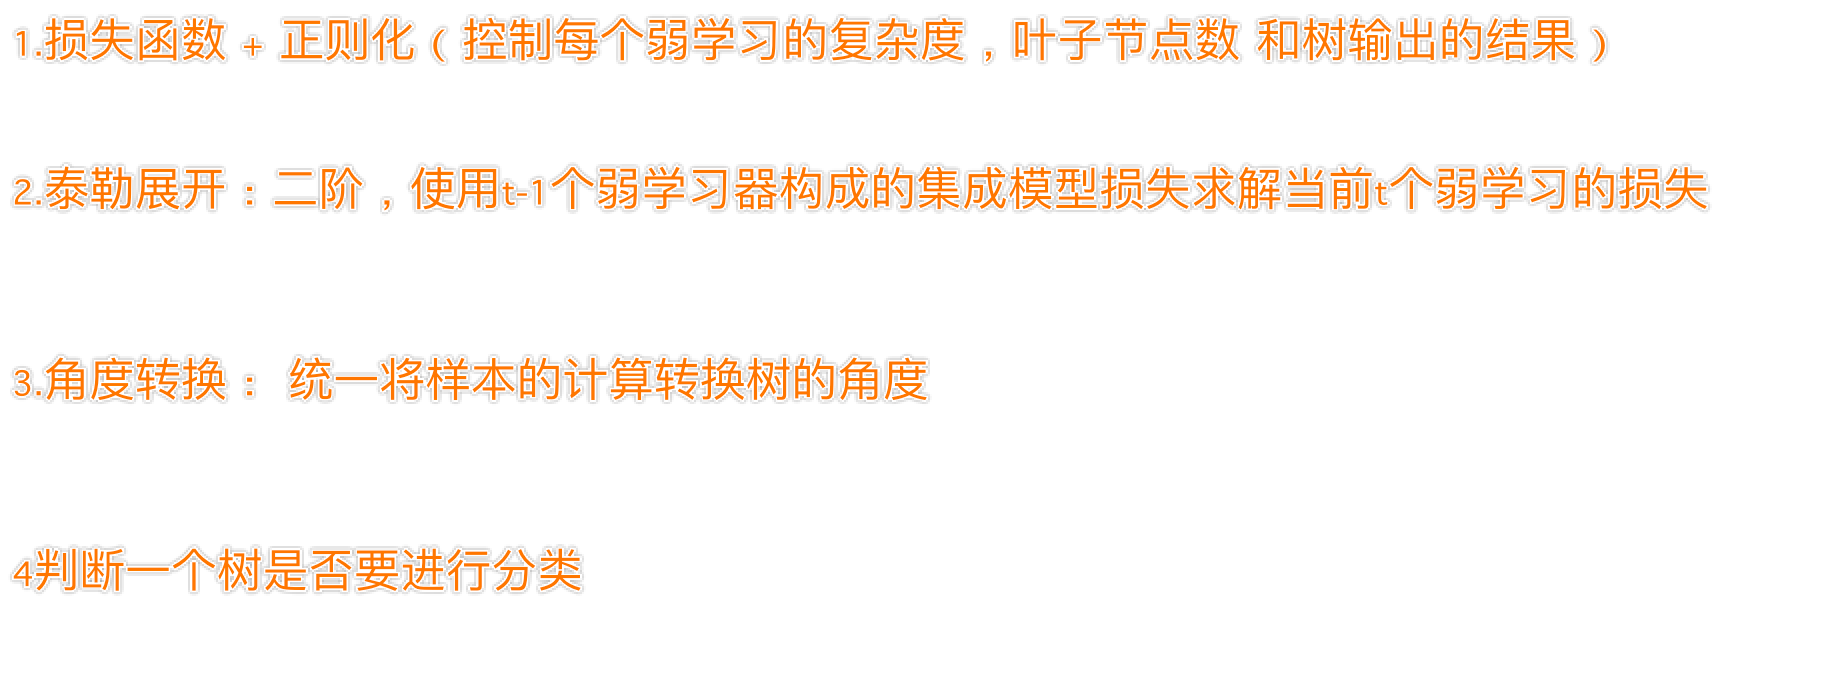
XGBoost(Extreme Gradient Boosting)全名叫极端梯度提升树,XGBoost是集成学习方法的王牌
8.4.1 算法思想
XGBoost 是对GBDT的改进:
- 求解损失函数极值时使用泰勒二阶展开
- 在损失函数中加入了正则化项
- XGB 自创一个树节点分裂指标。这个分裂指标就是从损失函数推导出来的。XGB 分裂树时考虑到了树的复杂度。
构建最优模型的方法是最小化训练数据的损失函数 。
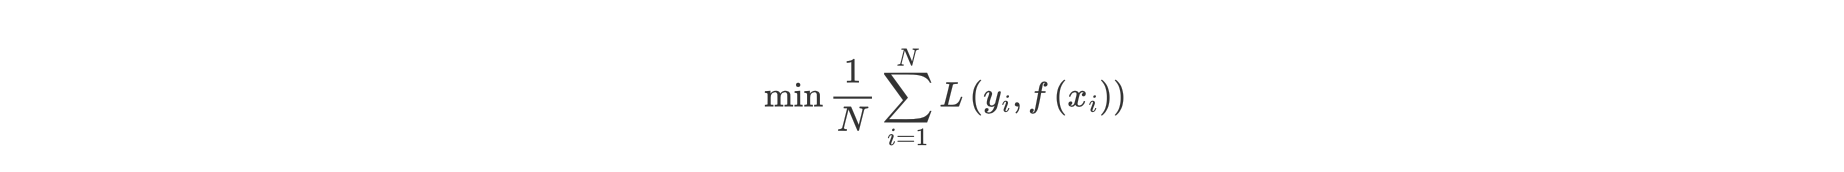
预测值和真实值经过某个函数计算出损失,并求解所有样本的平均损失,并且使得损失最小。这种方法训练得到的模型复杂度较高,很容易出现过拟合。因此,为了降低模型的复杂度,在损失函数中添加了正则化项,如下所示:
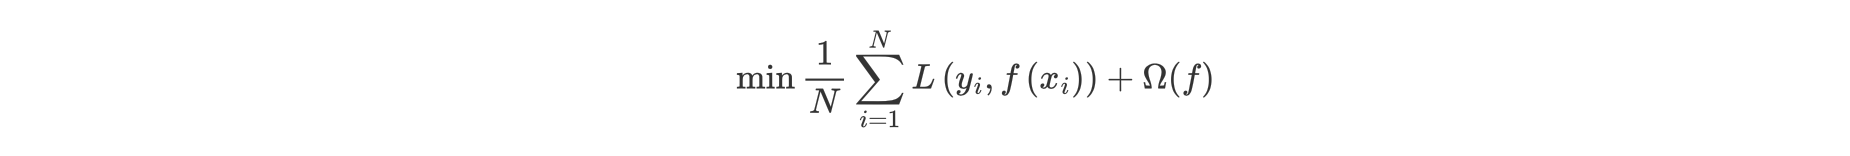
提高模型对未知数据的泛化能力。
8.4.2 目标函数
XGBoost(Extreme Gradient Boosting)是对梯度提升树的改进,并且在损失函数中加入了正则化项。
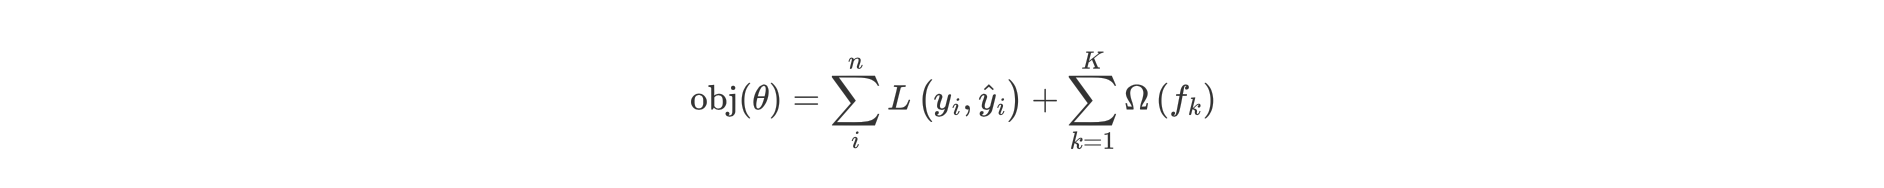
目标函数的第一项表示整个强学习器的损失,第二部分表示强学习器中 K 个弱学习器的复杂度。
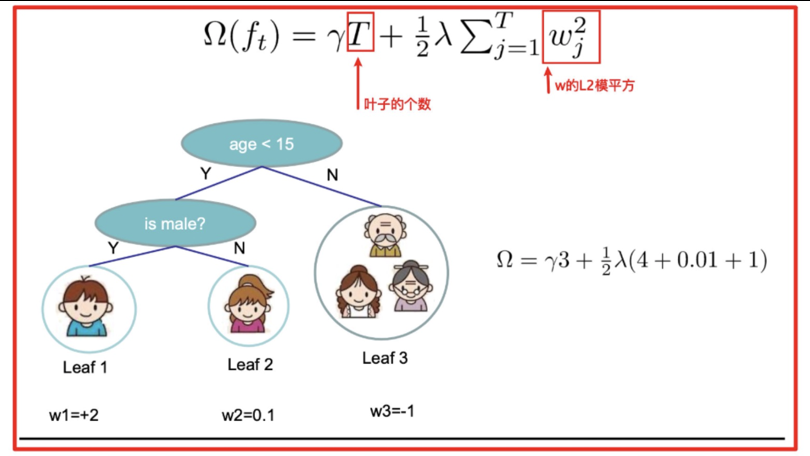
xgboost 每一个弱学习器的复杂度主要从两个方面来考量:

- γT 中的 T 表示一棵树的叶子结点数量,γ 是对该项的调节系数
- λ||w||2 中的 w 表示叶子结点输出值组成的向量,λ 是对该项的调节系数
模型复杂度的介绍
假设我们要预测一家人对电子游戏的喜好程度,考虑到年轻和年老相比,年轻更可能喜欢电子游戏,以及男性和女性相比,男性更喜欢电子游戏,故先根据年龄大小区分小孩和大人,然后再通过性别区分开是男是女,逐一给各人在电子游戏喜好程度上打分,如下图所示:
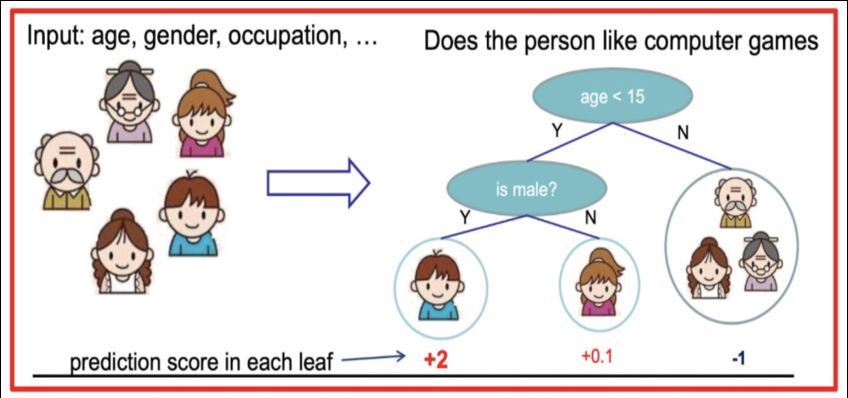
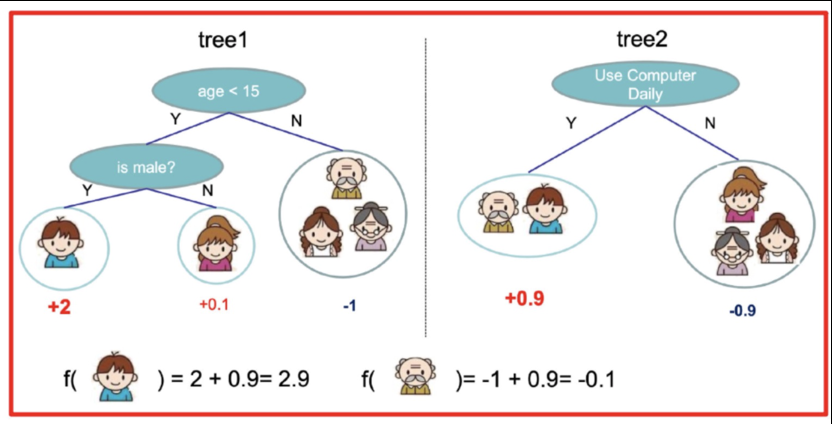
就这样,训练出了2棵树tree1和tree2,类似之前gbdt的原理,两棵树的结论累加起来便是最终的结论,所以:
- 小男孩的预测分数就是两棵树中小孩所落到的结点的分数相加:2 + 0.9 = 2.9。
- 爷爷的预测分数同理:-1 + 0.9 = -0.1。
具体如下图所示:
如下树tree1的复杂度表示为:
- 泰勒公式展开
我们直接对目标函数求解比较困难,通过泰勒展开将目标函数换一种近似的表示方式。接下来对 yi(t-1) 进行泰勒二阶展开,得到如下近似表示的公式:
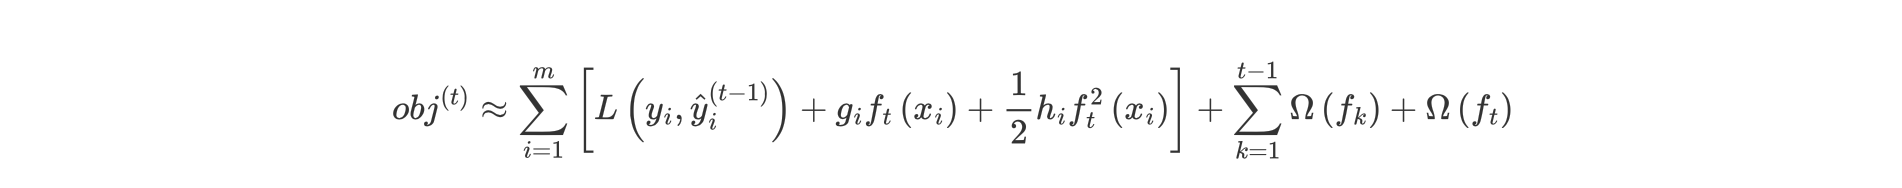
其中,gi 和 hi 的分别为损失函数的一阶导、二阶导:
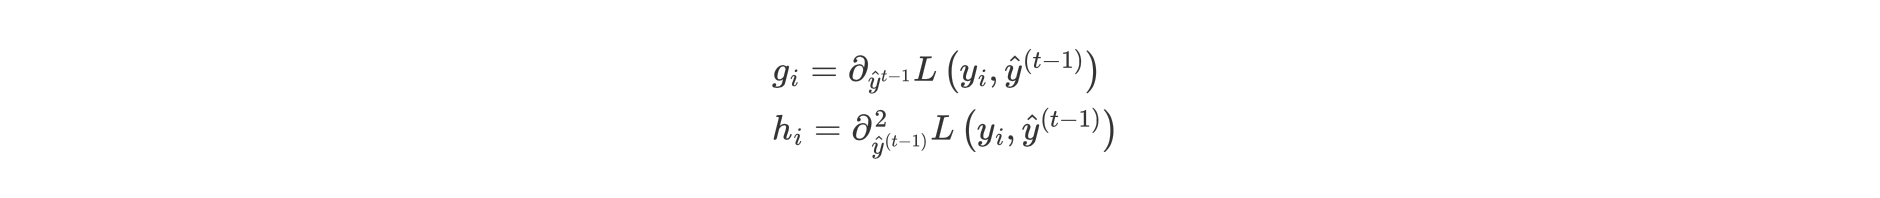
- 化简目标函数
我们观察目标函数,发现以下两项都是常数项,我们可以将其去掉。
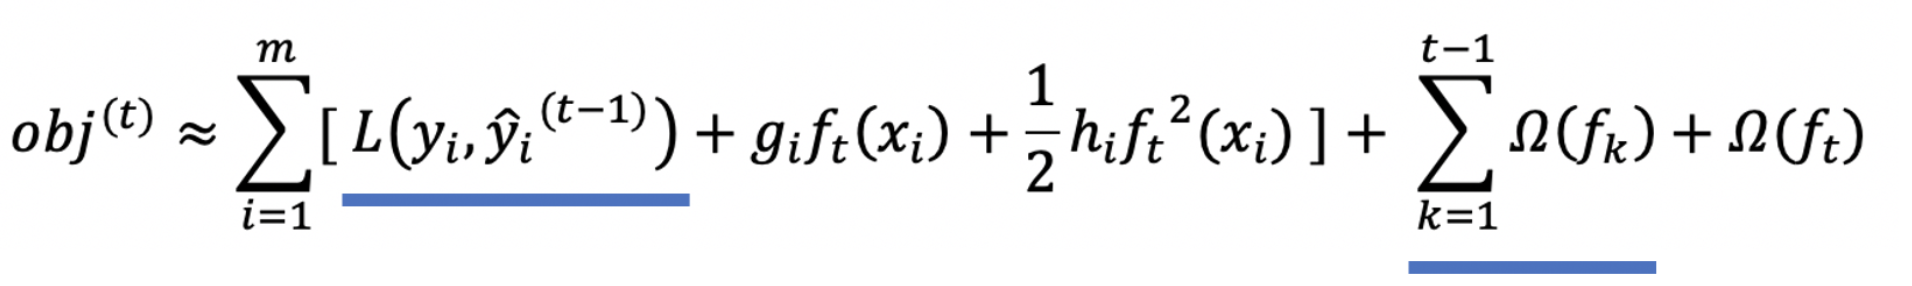
为什么说是常数项呢?这是因为当前学习器之前的学习器都已经训练完了,可以直接通过样本得出结果。化简之后的结果为:
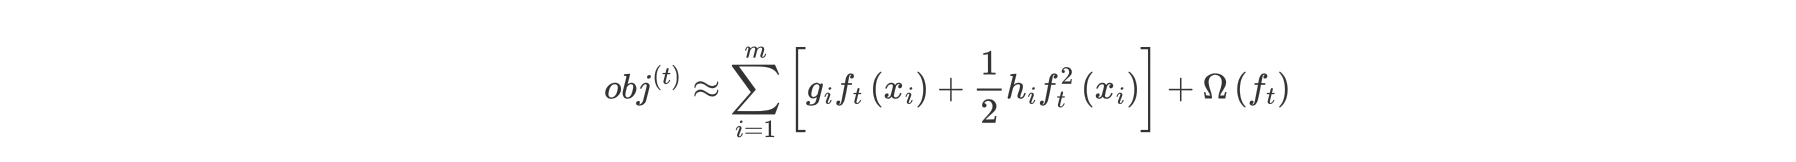
我们再将 Ω(ft) 展开,结果如下:
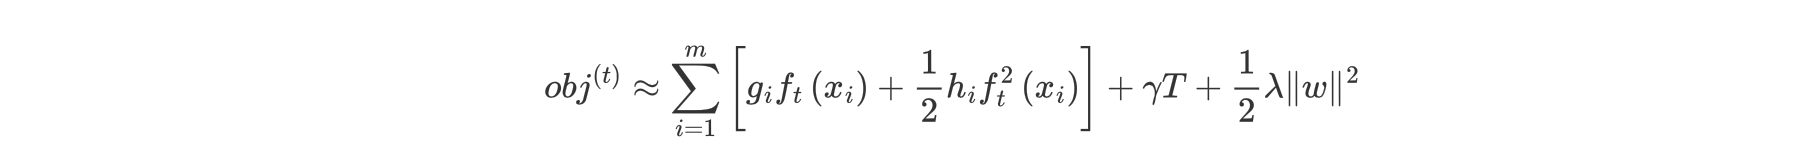
这个公式中只有 ft ,该公式可以理解为,当前这棵树如何构建能够降低损失。
- 问题再次转换
我们再次理解下这个公式表示的含义:
- gi 表示每个样本的一阶导,hi 表示每个样本的二阶导
- ft(xi) 表示样本的预测值
- T 表示叶子结点的数目
- ||w||2 由叶子结点值组成向量的模
现在,我们发现公式的各个部分考虑的角度不同,有的从样本角度来看,例如:ft(xi) ,有的从叶子结点的角度来看,例如:T、||w||2。我们下面就要将其转换为相同角度的问题,这样方便进一步合并项、化简公式。我们统一将其转换为从叶子角度的问题:
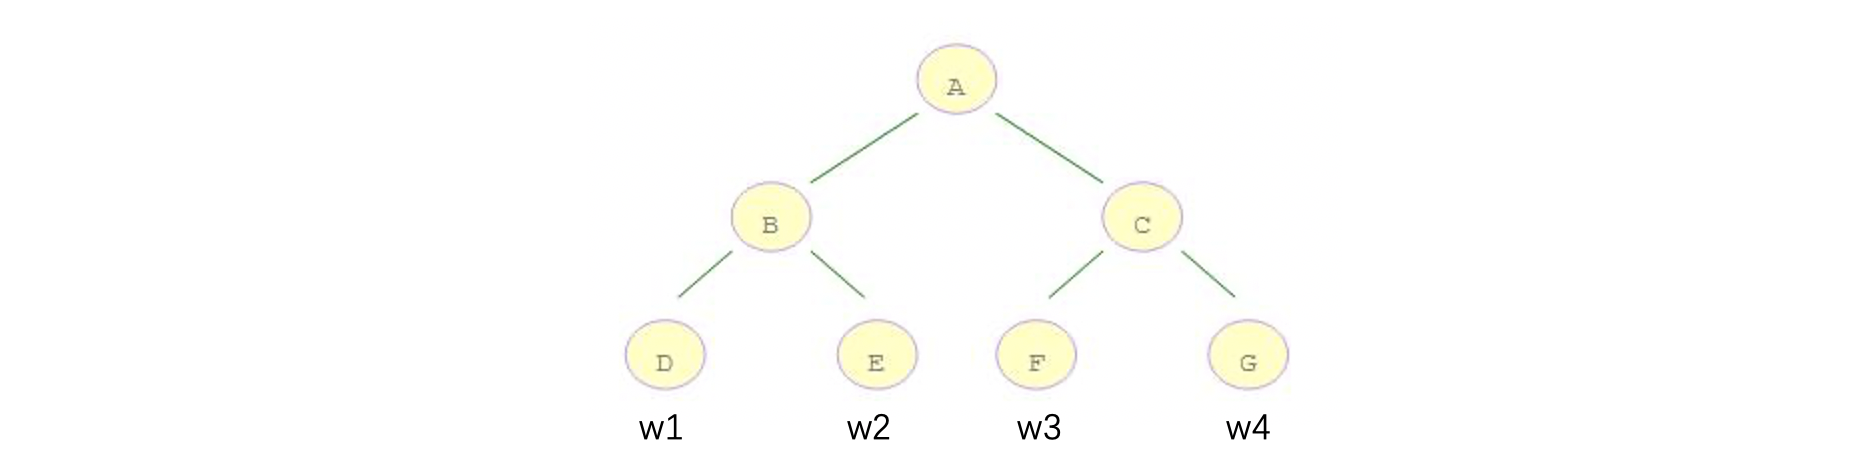
例如:10 个样本,落在 D 结点 3 个样本,落在 E 结点 2 个样本,落在 F 结点 2 个样本,落在 G 结点 3 个样本
D 结点计算: w1 * gi1 + w1 * gi2 + w1 * gi3 = (gi1 + gi2 + gi3) * w1
E 结点计算: w2 * gi4 + w2 * gi5 = (gi4 + gi5) * w2
F 结点计算: w3 * gi6 + w3 * gi6 = (gi6 + gi7) * w3
G 节点计算:w4 * gi8 + w4 * gi9 + w4 * gi10 = (gi8 + gi9 + gi10) * w4
gi ft(xi) 表示样本的预测值,我们将其转换为如下形式:
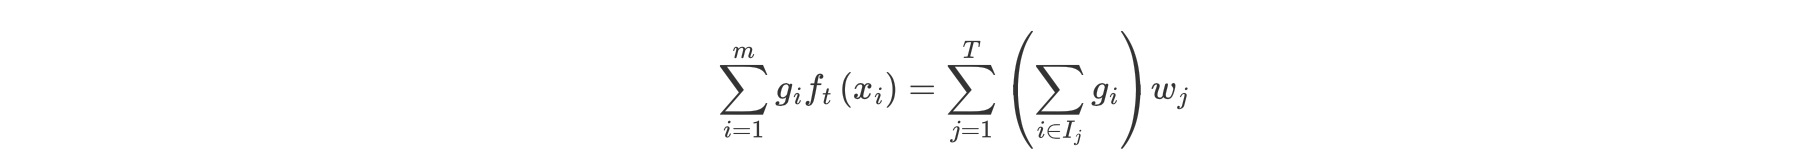
- wj 表示第 j 个叶子结点的值
- gi 表示每个样本的一阶导
hift2(xi) 转换从叶子结点的问题,如下:
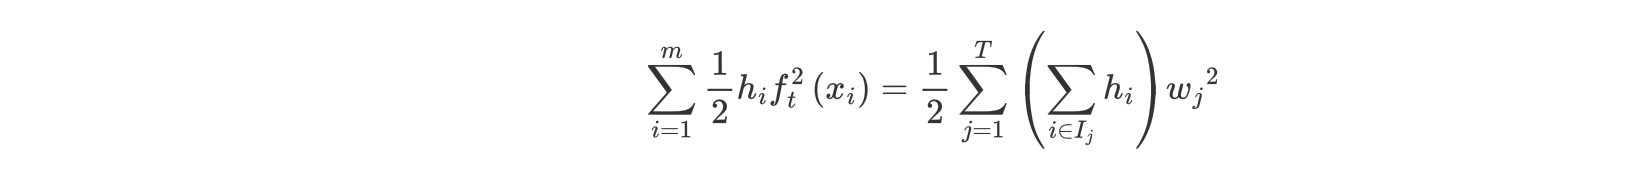
λ||w||2 由于本身就是从叶子角度来看,我们将其转换一种表示形式:

我们重新梳理下整理后的公式,如下:
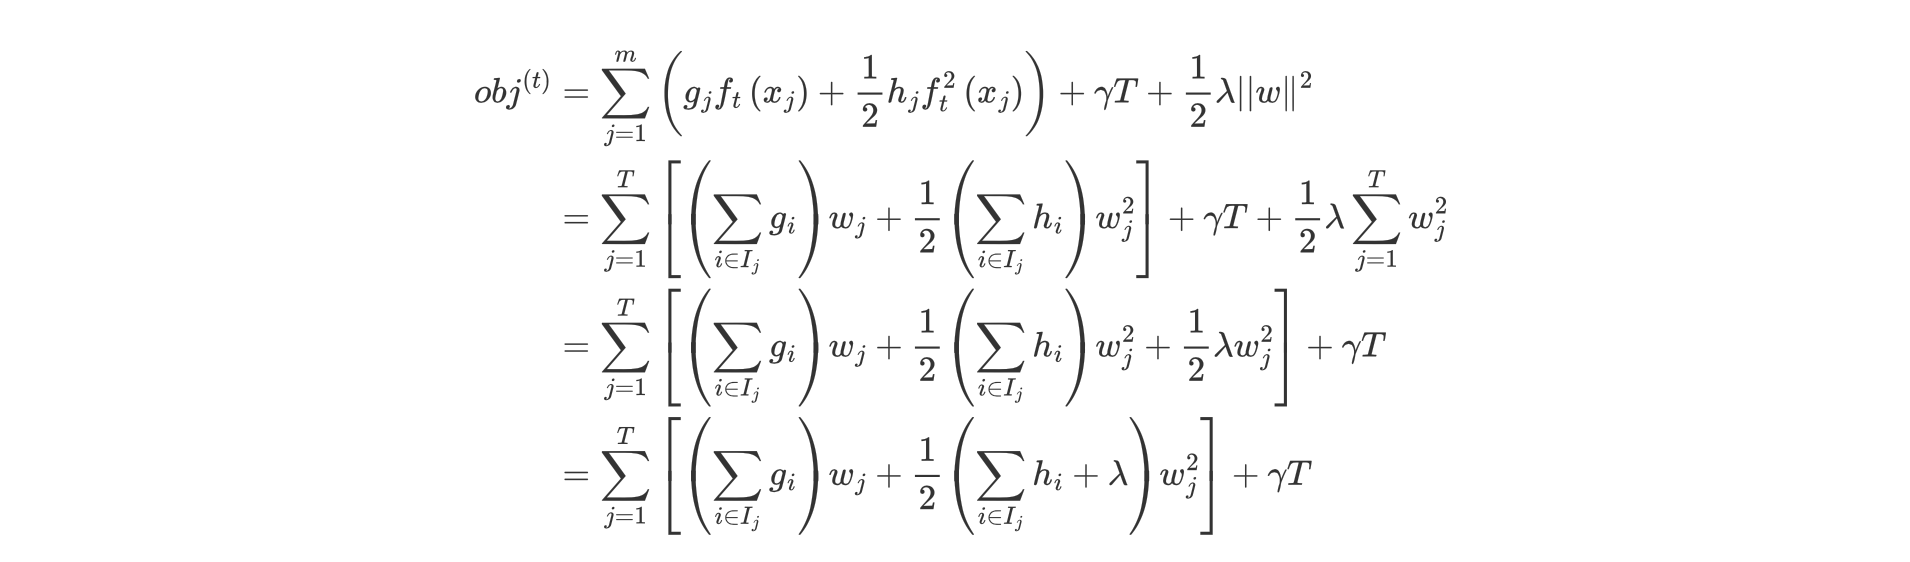
上面的公式太复杂了,我们令:
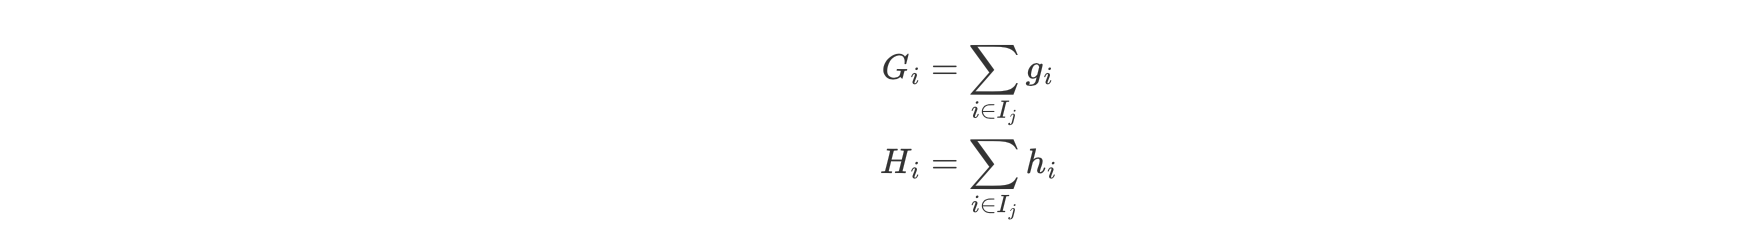
Gi 表示样本的一阶导之和,Hi 表示样本的二阶导之和,当确定损失函数时,就可以通过计算得到结果。
现在我们的公式变为:
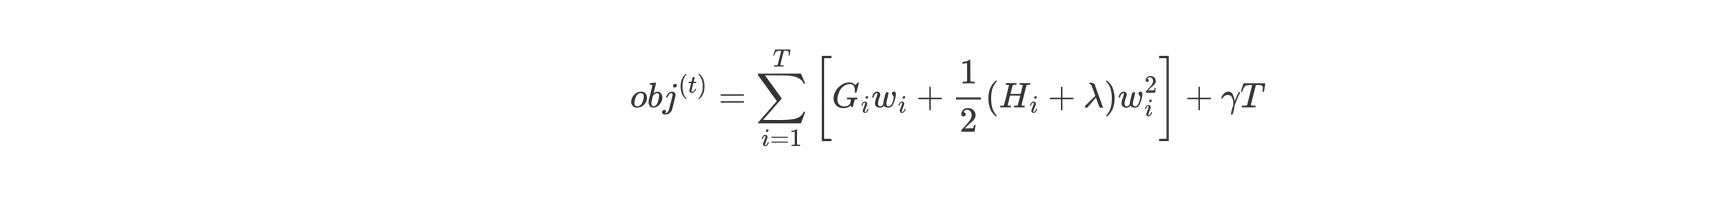
- 对叶子结点求导
此时,公式可以看作是关于叶子结点 w 的一元二次函数,我们可以对 w 求导并令其等于 0,可得到 w 的最优值,将其代入到公式中,即可再次化简上面的公式。
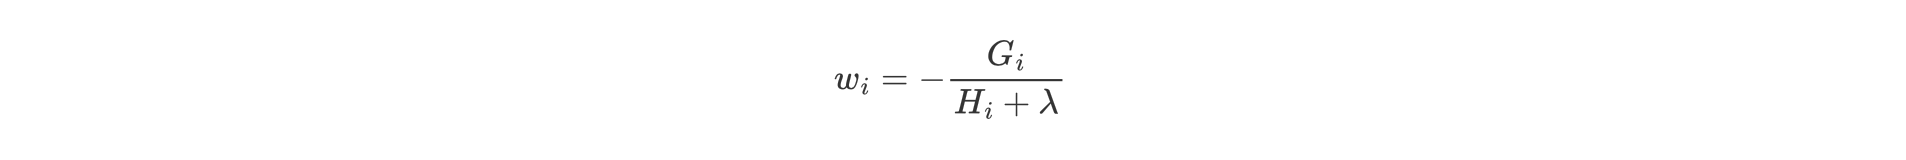
将 wj 代入到公式中,即可得到:
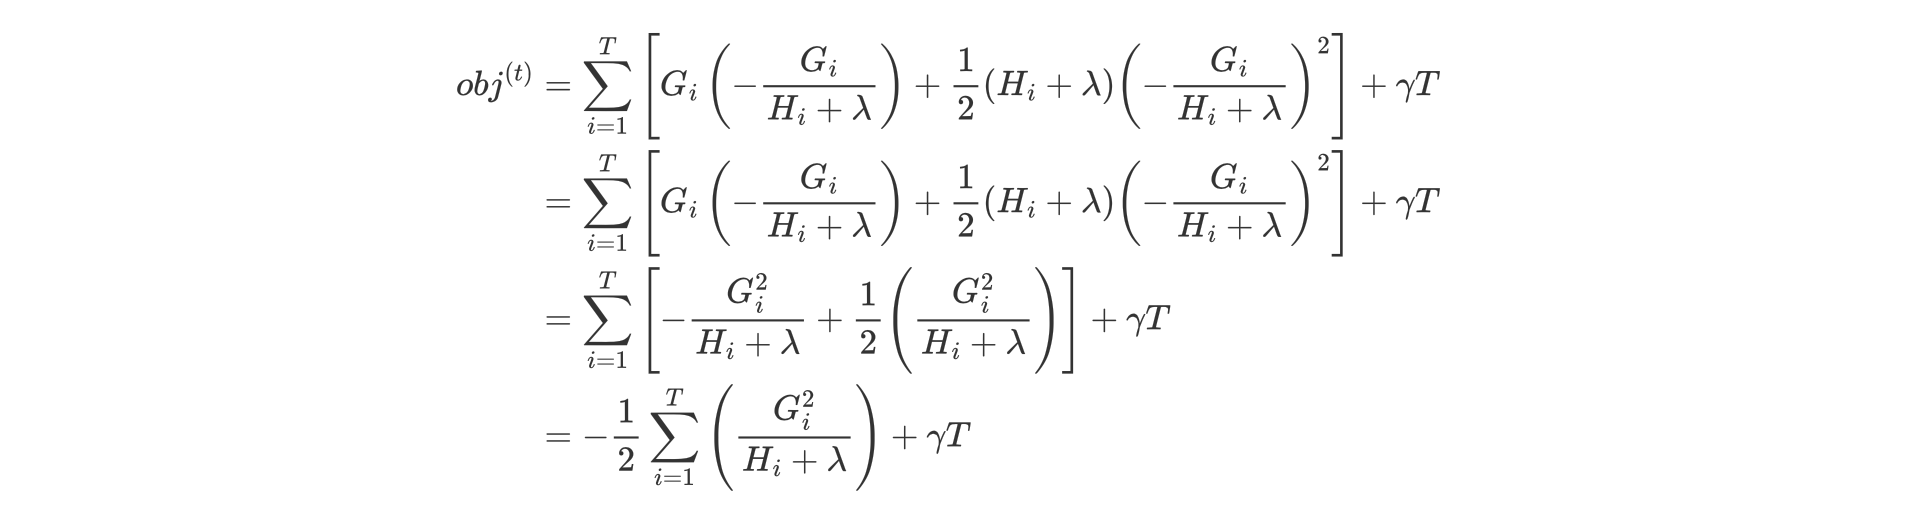
- XGBoost的树构建方法
该公式也叫做打分函数 (scoring function),它可以从树的损失函数、树的复杂度两个角度来衡量一棵树的优劣。
这个公式,我们怎么用呢?
当我们构建树时,可以用来选择树的最佳划分点。
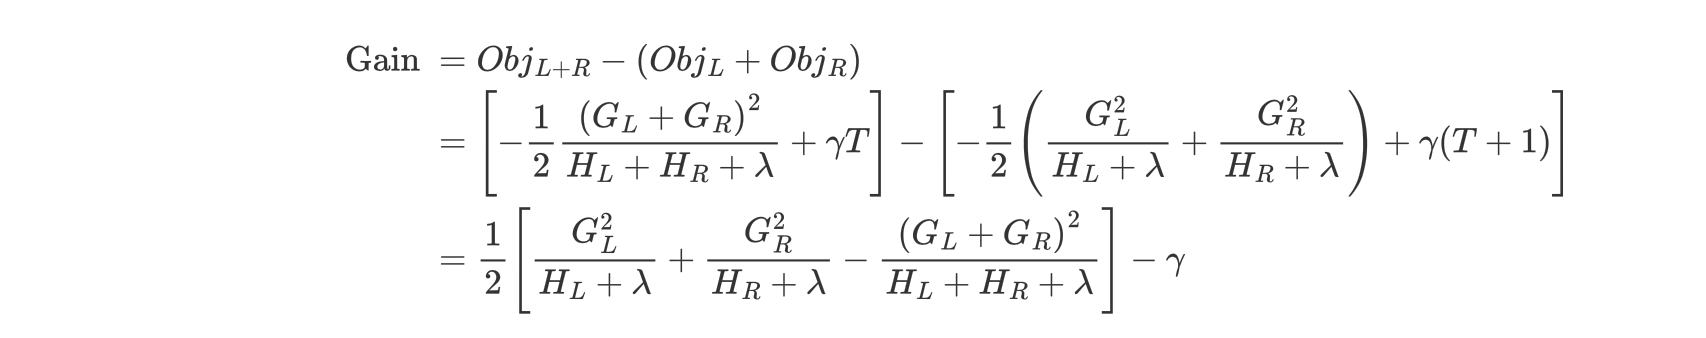
过程如下:
- 对树中的每个叶子结点尝试进行分裂
- 计算分裂前 - 分裂后的分数:
- 如果gain > 0,则分裂之后树的损失更小,我们会考虑此次分裂
- 如果gain< 0,说明分裂后的分数比分裂前的分数大,此时不建议分裂
- 当触发以下条件时停止分裂:
- 达到最大深度
- 叶子结点样本数量低于某个阈值
- 等等…
9. 时间序列预测
9.1基于统计学
统计朴素法:今天的值作为明天的预测值
简单平均法:历史上所有值的平均值作为明天的预测值
移动平均法:历史上一段时间窗口内的平均值作为明天的预测值
简单指数平滑法:历史上的值加权平均作为明天的预测值,加权方法是指数方式(保证近期权重更大,远期权重更小)
霍尔特(Holt)线性趋势法:一个水平方程(Lt),一个趋势方程(Bt),再把二者计算的结果加起来
AR自回归模型:历史上一段时间窗口内的值预测出明天的预测值
MA移动平均模型:均值加上白噪声项
ARIMA差分自回归移动平均模型:自回归与移动平均结果之和